
Claude Code·Cowork 텔레메트리 비용과 위험 분석
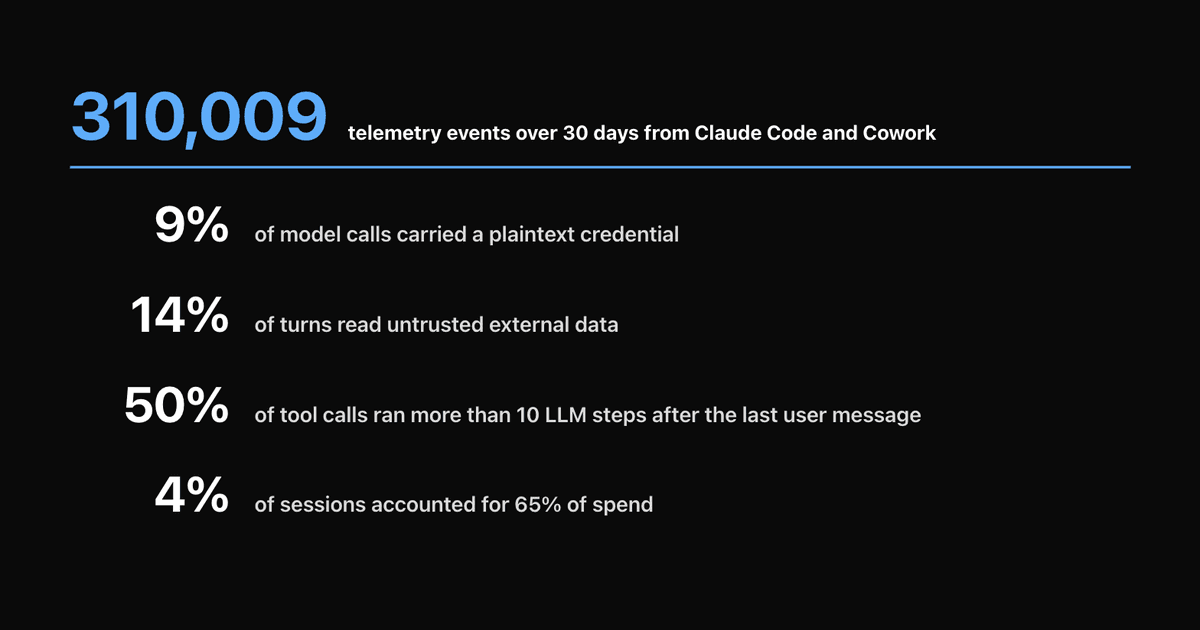
Claude Code와 Cowork에서 30일 동안 수집한 310,009개의 텔레메트리 이벤트를 분석한 결과입니다.
- 9%의 모델 호출에 평문 자격 증명이 포함되어 있었습니다.
- 14%의 턴에서 신뢰할 수 없는 외부 데이터를 읽었습니다.
- 50%의 도구 호출이 마지막 사용자 메시지 이후 10개 이상의 LLM 단계 동안 실행되었습니다.
- 4%의 세션이 전체 지출의 65%를 차지했습니다.
*한 턴은 하나의 사용자 프롬프트 이후의 모든 에이전트 동작을 의미합니다. 턴의 단계는 Claude가 사고하고 도구를 호출하는 한 라운드입니다.*
OTel 에이전트 모니터링의 배경
조직 전반에서 점점 더 많은 에이전트형 도구가 더 큰 기능과 범위로 채택됨에 따라, 에이전트 동작을 모니터링하고 감독할 필요성도 커지고 있습니다. 또한 Claude의 Dynamic Workflows처럼 최대 1000개의 하위 에이전트를 생성해 작업을 완료할 수 있게 하는 기능이 배포되면서, 비용을 추적하고 사용량을 최적화하는 일이 우선순위가 되고 있습니다.
Claude와 다른 많은 에이전트형 솔루션은 OpenTelemetry(OTel)을 지원합니다. OTel을 사용하면 관리자가 수집기를 배포하고 사용자 세션에서 텔레메트리 이벤트를 받을 수 있으며, 도구 호출 승인 같은 보안 관련 이벤트부터 요청 비용 같은 비용 관련 지표까지 포함됩니다.
이번 실험에서는 일반화 가능한 조직의 관심사를 파악하기 위해, 10명으로 이루어진 교차 기능 팀의 OTel 데이터¹를 살펴봅니다. 실제로 배포된 에이전트에서 어떤 위험이 나타나는지, 그리고 비용을 유발하는 요인은 무엇인지에 초점을 맞춥니다.
¹ 분석한 OTel 데이터는 기업 파트너와의 협업을 통해 제공되었으며, 이 글에서는 익명 처리했습니다.
결과
| 항목 | 결과 |
|---|---|
| 민감한 데이터 | 모델 호출의 9%에서 자격 증명이 평문으로 포함되어 있었으며, 66개의 명령이 자격 증명을 출력해 이후 5,840개의 LLM 호출 동안 Anthropic으로 전송되었습니다. |
| 신뢰할 수 없는 입력 | 턴의 14%에서 신뢰할 수 없는 외부 텍스트를 읽었고, 총 135MB에 달했습니다. MCP 서버가 웹 가져오기와 웹 검색보다 더 큰 비중을 차지했습니다. |
| 외부 작업 | 650개의 외부 호스트에 연결되었으며, 그 연결의 56%는 사용자의 마지막 메시지 이후 10개 이상의 LLM 호출이 지난 뒤에 이루어졌습니다. |
| 자율성 | 도구 호출의 50%가 마지막 사용자 메시지 이후 10개 이상의 LLM 단계 동안 실행되었고, 턴의 13%는 사람의 입력 없이 5분 이상 실행되었습니다. |
| 비용 | 세션의 4%가 전체 지출의 65%를 차지했습니다. Fable 5가 모델 호출의 27%로 전체 청구액의 54%를 차지했고, 캐시 읽기가 그중 약 68%를 차지했습니다. |
9%의 경우, Claude는 평문 자격 증명을 안전하지 않게 처리했습니다
작업을 수행하려면 Claude가 사용자를 대신해 동작하기 위해 자격 증명을 사용해야 합니다. 하지만 자격 증명을 직접 읽으면 세 가지 문제가 생깁니다.
- 자격 증명이 이후의 모든 LLM 호출마다 Anthropic으로 전송됩니다.
- 세션 대화 기록에 남고, 설정에 따라 OTel 로그에도 남습니다.
- 에이전트의 컨텍스트에 남아, 간접 프롬프트 주입 공격이 이를 노려 유출할 수 있습니다.
자격 증명을 더 안전하게 처리하기 위해 Claude는 자격 증명을 직접 읽지 않고 사용하도록 훈련되었습니다. 예를 들어 비밀 값을 출력하지 않은 채 자식 프로세스에 전달하거나, HTTP 헤더에 프로그래밍 방식으로 설정하는 방식입니다. Claude는 연구 기간 동안 이를 2,979회 수행했습니다.
하지만 Claude가 완벽한 것은 아니었습니다. Claude는 자격 증명을 그대로 출력한 적이 66회 있었고, 그 결과 해당 값이 컨텍스트, 대화 기록, 그리고 Anthropic으로의 API 요청에 포함되었습니다. 이는 자격 증명이 사용된 전체 시간의 약 2%에 불과하지만, 출력된 값은 압축(compaction)될 때까지 컨텍스트에 남기 때문에, 평문 자격 증명은 전체 시간의 9% 동안 존재했습니다. 즉, 342개 세션 중 32개에서 Anthropic으로 향한 65,892건의 LLM API 호출 중 5,840건에 평문 자격 증명이 포함되었습니다.
66건의 안전하지 않은 읽기 중 절반에 조금 못 미치는 비율은 팀의 비밀 정보 관리자에서 자격 증명을 가져왔고, 약 3분의 1은 실행 중인 프로세스의 환경 변수를 덤프했으며, 나머지는 로컬 .env 파일, 클러스터 비밀, 또는 macOS 키체인 항목을 출력했습니다.
턴의 14%에서 Claude는 신뢰할 수 없는 외부 데이터를 읽었습니다
Claude가 도구를 실행할 때마다 도구의 출력은 모델이 읽는 텍스트가 됩니다. 조직 밖에서 온 데이터는 신뢰할 수 없는 것으로 간주되며, Claude를 조작해 데이터 유출, 사용자 대상 피싱, 또는 연결된 다른 도구 전반에서 원치 않는 작업을 수행하게 만드는 프롬프트 인젝션을 포함할 수 있습니다. 아래에서는 Claude가 처리한 135MB의 외부 데이터가 어디에서 왔는지 분석합니다.
Claude의 신뢰할 수 없는 데이터 출처
| 출처 | 데이터 양 | 비중 |
|---|---|---|
| MCP 서버 | 70.1 MB | 52% |
| 웹 페이지 가져오기 | 44.5 MB | 33% |
| 웹 검색 결과 | 16.5 MB | 12% |
| 외부 호스트에 도달하는 셸 명령 | 3.9 MB | 3% |
가장 중요한 신뢰할 수 없는 데이터의 출처는 MCP 서버였고, 그다음은 웹 가져오기와 웹 검색이었다. 전체 턴의 14%에서 신뢰할 수 없는 텍스트를 읽었으며(1,308턴), 그중 중앙값은 2.9KB였다. 열 번 중 한 번은 141KB를 넘게 읽었고, 백 번 중 한 번은 833KB를 넘었으며, 12턴은 각각 1MB 이상을 읽었다.
이달 동안 MCP 서버에 3,500회의 호출이 있었고, 49개 서버에 걸쳐 평균 각 20KB씩이었다. 단일 MCP 결과 중 가장 큰 것은 1.07MB였다. 팀원 10명 전체로 보면, 한 사람당 평균 거의 5개의 고유한 MCP 서버를 사용했으며, 한 달 동안 총 49개의 MCP 서버가 사용되었다. 이는 최근 여러 업계에서 관찰한 바와도 일치한다. MCP 서버 사용 요청을 검토하고 MCP 서버의 안전한 사용을 관리하는 일이 중요한 할 일로 떠오르고 있다.
웹 가져오기와 웹 검색을 합쳐 61MB를 반환했지만, 그 데이터의 일부만 메인 에이전트에 도달했다. Claude의 하니스는 더 작은 모델(Haiku)을 사용해 웹 데이터를 전처리하고 메인 에이전트와 관련된 부분을 추출함으로써, 관련 없는 웹 데이터가 컨텍스트 윈도우를 오염시키는 것을 줄인다. 이 단계는 결국 프롬프트 인젝션이 메인 에이전트에 의해 처리될 위험을 낮추지만, 위험을 없애지는 못한다. 프롬프트 인젝션은 자신을 중요한 내용처럼 보이게 하여 Haiku를 조종해, 메인 에이전트로 전달되는 데이터에 주입된 내용을 포함시키게 만들 가능성이 높기 때문이다.
웹 검색 이외에도, bash를 통해 255개의 외부 호스트에 접속했다. 여기에는 GitHub 같은 팀이 사용하는 서비스용 API와, 웹 전용 도구 대신 curl을 사용해 가져온 임의의 웹사이트가 섞여 있었다.
도구 사용의 50%는 마지막 사용자 상호작용 이후 10개가 넘는 에이전트 단계 뒤에 발생했다
사용자가 프롬프트를 입력하면 Claude는 루프 안에서 동작한다. LLM이 프롬프트를 처리하고, 도구를 실행하고, 결과를 읽은 뒤, 중단할지 더 많은 도구를 실행할지 선택한다. 하나의 ‘턴’은 하나의 사용자 프롬프트 이후 에이전트가 수행하는 모든 일을 설명하고, 하나의 ‘스텝’은 에이전트가 생각한 뒤 도구를 호출하는 한 번의 반복을 뜻하며, 그 에이전트가 생성한 하위 에이전트의 스텝도 함께 센다.
중앙값 프롬프트 길이는 86자였고, 중앙값 턴은 3번의 모델 호출(LLM 처리 단계)을 했다. 약 100턴 중 1턴은 72개가 넘는 처리 단계를 거쳤고, 가장 긴 턴은 1,102개의 처리 단계를 가졌다.
우리는 에이전트 처리 단계가 늘어남에 따라 호출되는 도구의 비율을 측정해, 에이전트가 사용자 프롬프트로부터 한참 지난 뒤 민감한 행동을 취할 위험을 가늠했다. 그 시점에는 에이전트의 작업이 사용자의 원래 의도에서 벗어났을 수 있기 때문이다.
중앙값 도구 호출은 사용자 메시지 이후 10개의 처리 단계가 지난 뒤에 실행되었다. 도구 호출의 10%는 마지막 사용자 프롬프트 이후 160개가 넘는 처리 단계가 지나 발생했고, 1%는 마지막 사용자 프롬프트 이후 782개가 넘는 처리 단계가 지난 뒤 발생했다.
파일을 삭제하거나, 코드를 푸시하거나, 커밋하거나, 네트워크에 도달하는 명령은 일반적으로 사용자와 더 가까운 시점에 실행되었는데, 중앙값은 5개의 처리 단계였다. 하지만 열 번 중 한 번은 56개가 넘는 처리 단계가 지난 뒤였고, rm -rf 명령 하나는 마지막 사용자 상호작용 이후 920개의 처리 단계가 지난 뒤 실행되었다.
13%의 턴은 사람의 입력 없이 5분 이상 실행되었고, 2%는 15분 이상, 1% 미만은 1시간 이상 실행되었다.
Fable은 LLM 호출의 27%만 차지하면서 지출의 54%를 차지했다
이 분석을 진행하는 동안 8개의 모델이 사용되었다. 지출의 89%는 Fable 5(총 비용의 54%, 8,573달러, 모델 호출의 27%에 사용)와 Opus 5(비용의 36%, 5,699달러, 모델 호출의 50%에 사용) 사이에 나뉘었다.
모델별 지출과 모델 호출
| 모델 | 지출 비율 | 호출 비율 |
|---|---|---|
| fable-5 | 54% ($8,573) | 27% |
| opus-5 | 36% ($5,699) | 50% |
| opus-4-8 | 5% ($732) | 4% |
| sonnet-5 | 4% ($571) | 7% |
| sonnet-4-6 | 1% ($194) | 5% |
| opus-4-6 | 1% ($140) | 2% |
| haiku-4-5 | <1% ($46) | 5% |
Fable은 Opus보다 수행한 작업 수가 45% 적었지만, 비용은 50% 더 들었다. 이는 주로 평균 컨텍스트 사용량과 토큰당 가격이라는 두 가지 요인 때문이었다. Fable 5에 대한 Anthropic 호출은 평균 319,000개의 토큰을 사용한 반면, Opus 5는 201,000개였다. 또한 Fable의 비용은 백만 토큰당 1.31달러(입력, 출력, 캐시된 토큰을 합친 평균)였고, Opus는 0.75달러였으며, 그 결과 모델 호출당 평균 비용은 Fable이 0.42달러, Opus가 0.15달러였다.
모든 모델에서 토큰의 97%는 캐시 읽기였습니다(에이전트가 자신의 대화를 다시 읽는 것). 이로 인해 캐시된 토큰은 입력 요금의 10분의 1로 청구되며, Fable 5에서는 백만 토큰당 $1.00, Opus 5에서는 $0.50이어서 전체 지출의 약 68%를 차지했습니다.
반대로 Haiku 4.5에 대한 모델 호출의 5%는 전체 지출의 1%도 되지 않았습니다. 이러한 사용은 웹 가져오기와 웹 검색 결과를 전처리하는 2,067회의 호출(불필요한 컨텍스트가 메인 모델에 도달하는 것을 방지함)과 세션 제목 생성 같은 보조 작업이 대부분을 차지했습니다.
지출은 세션별로 고르게 나뉘지 않았습니다. 가장 저렴한 절반의 세션이 전체 청구액의 2%만 차지했습니다. $300를 초과한 12개 세션이 지출의 65%를 차지했고, 그중 두 세션만으로도 32%를 차지했습니다. 두 세션 모두 주로 Fable을 사용했으며, 일주일 넘게 열어 둔 채 매일 재개되었기 때문에 각 LLM 호출마다 평균적으로 약 50만 개의 캐시된 토큰에 대한 컨텍스트 비용이 지불되었습니다. 이는 소수의 에이전트 작업과 팀 내 소수의 파워 유저가 지출의 대부분을 차지하는 패턴을 더욱 확장한 것이었습니다.
세션 비용 구간별 세션 비중과 지출 비중
| 단위 | 비용 구간 | 개수 | 세션 비중 | 지출 | 지출 비중 |
|---|---|---|---|---|---|
| 세션 | $0.10 미만 | 8 | 2% | $0.49 | <1% |
| 세션 | $0.10 ~ $0.30 | 11 | 3% | $2.69 | <1% |
| 세션 | $0.30 ~ $1 | 50 | 15% | $31.59 | <1% |
| 세션 | $1 ~ $3 | 86 | 25% | $154 | 1% |
| 세션 | $3 ~ $10 | 76 | 22% | $449 | 3% |
| 세션 | $10 ~ $30 | 59 | 17% | $910 | 6% |
| 세션 | $30 ~ $100 | 26 | 8% | $1,505 | 9% |
| 세션 | $100 ~ $300 | 14 | 4% | $2,594 | 16% |
| 세션 | $300 ~ $1,000 | 10 | 3% | $5,233 | 33% |
| 세션 | $1,000 ~ $3,000 | 2 | 1% | $5,079 | 32% |
출처
- 원문: https://www.promptarmor.com/resources/claude-cost-and-risk-otel-findings (2026-09-24 · sarelta)