
MCP에서 코드 실행을 활용한 에이전트 효율화

MCP 코드 실행으로 에이전트 효율화
Model Context Protocol (MCP)는 AI 에이전트를 외부 시스템에 연결하기 위한 개방형 표준입니다. 에이전트를 도구와 데이터에 연결하려면 전통적으로 각 조합마다 맞춤형 통합이 필요했으며, 이로 인해 파편화와 중복 작업이 생겨 진정으로 연결된 시스템을 확장하기가 어려웠습니다. MCP는 보편적인 프로토콜을 제공합니다. 개발자는 에이전트에 MCP를 한 번 구현하기만 하면, 다양한 통합 생태계를 바로 활용할 수 있습니다.
2024년 11월 MCP를 출시한 이후 채택 속도는 매우 빨랐습니다. 커뮤니티는 수천 개의 MCP 서버를 구축했고, SDK는 주요 프로그래밍 언어 모두에서 사용할 수 있으며, 업계는 MCP를 에이전트를 도구와 데이터에 연결하는 사실상의 표준으로 채택했습니다.
오늘날 개발자들은 수십 개의 MCP 서버에 걸쳐 수백 개 또는 수천 개의 도구에 접근할 수 있는 에이전트를 일상적으로 만들고 있습니다. 하지만 연결된 도구 수가 늘어날수록, 모든 도구 정의를 처음부터 한꺼번에 불러오고 중간 결과를 컨텍스트 윈도를 통해 전달하는 방식은 에이전트를 느리게 하고 비용을 증가시킵니다.
이 글에서는 코드 실행이 에이전트가 MCP 서버와 더 효율적으로 상호작용하도록 어떻게 돕는지, 더 적은 토큰을 사용하면서 더 많은 도구를 처리하는 방법을 살펴봅니다.
도구로 인한 과도한 토큰 소비는 에이전트의 효율을 떨어뜨립니다
MCP 사용이 확대되면 에이전트 비용과 지연 시간을 늘릴 수 있는 두 가지 일반적인 패턴이 있습니다:
- 도구 정의가 컨텍스트 윈도를 과부하합니다;
- 중간 도구 결과가 추가 토큰을 소비합니다.
1. 도구 정의가 컨텍스트 윈도를 과부하합니다
대부분의 MCP 클라이언트는 모든 도구 정의를 처음부터 직접 컨텍스트에 로드하고, 직접적인 도구 호출 문법을 사용해 모델에 노출합니다. 이러한 도구 정의는 다음과 같을 수 있습니다:
gdrive.getDocument
Description: Retrieves a document from Google Drive
Parameters:
documentId (required, string): The ID of the document to retrieve
fields (optional, string): Specific fields to return
Returns: Document object with title, body content, metadata, permissions, etc.salesforce.updateRecord
Description: Updates a record in Salesforce
Parameters:
objectType (required, string): Type of Salesforce object (Lead, Contact, Account, etc.)
recordId (required, string): The ID of the record to update
data (required, object): Fields to update with their new values
Returns: Updated record object with confirmation도구 설명은 컨텍스트 윈도 공간을 더 많이 차지해 응답 시간과 비용을 증가시킵니다. 에이전트가 수천 개의 도구에 연결되어 있는 경우, 요청을 읽기 전에 수십만 개의 토큰을 처리해야 할 수도 있습니다.
2. 중간 도구 결과가 추가 토큰을 소비합니다
대부분의 MCP 클라이언트는 모델이 MCP 도구를 직접 호출할 수 있게 합니다. 예를 들어 에이전트에게 이렇게 요청할 수 있습니다: "Google Drive에서 회의 녹취록을 다운로드해서 Salesforce 리드에 첨부해 줘."
모델은 다음과 같은 호출을 수행합니다:
TOOL CALL: gdrive.getDocument(documentId: "abc123")
→ returns "Discussed Q4 goals...\n[full transcript text]"
(loaded into model context)
TOOL CALL: salesforce.updateRecord(
objectType: "SalesMeeting",
recordId: "00Q5f000001abcXYZ",
data: { "Notes": "Discussed Q4 goals...\n[full transcript text written out]" }
)
(model needs to write entire transcript into context again)모든 중간 결과는 모델을 거쳐야 합니다. 이 예에서는 전체 호출 기록이 두 번 흐릅니다. 2시간짜리 영업 회의라면 추가로 50,000 토큰을 처리해야 할 수도 있습니다. 더 큰 문서는 컨텍스트 윈도 제한을 초과해 워크플로가 깨질 수도 있습니다.
대용량 문서나 복잡한 데이터 구조의 경우, 도구 호출 사이에서 데이터를 복사할 때 모델이 실수를 할 가능성도 더 높아집니다.
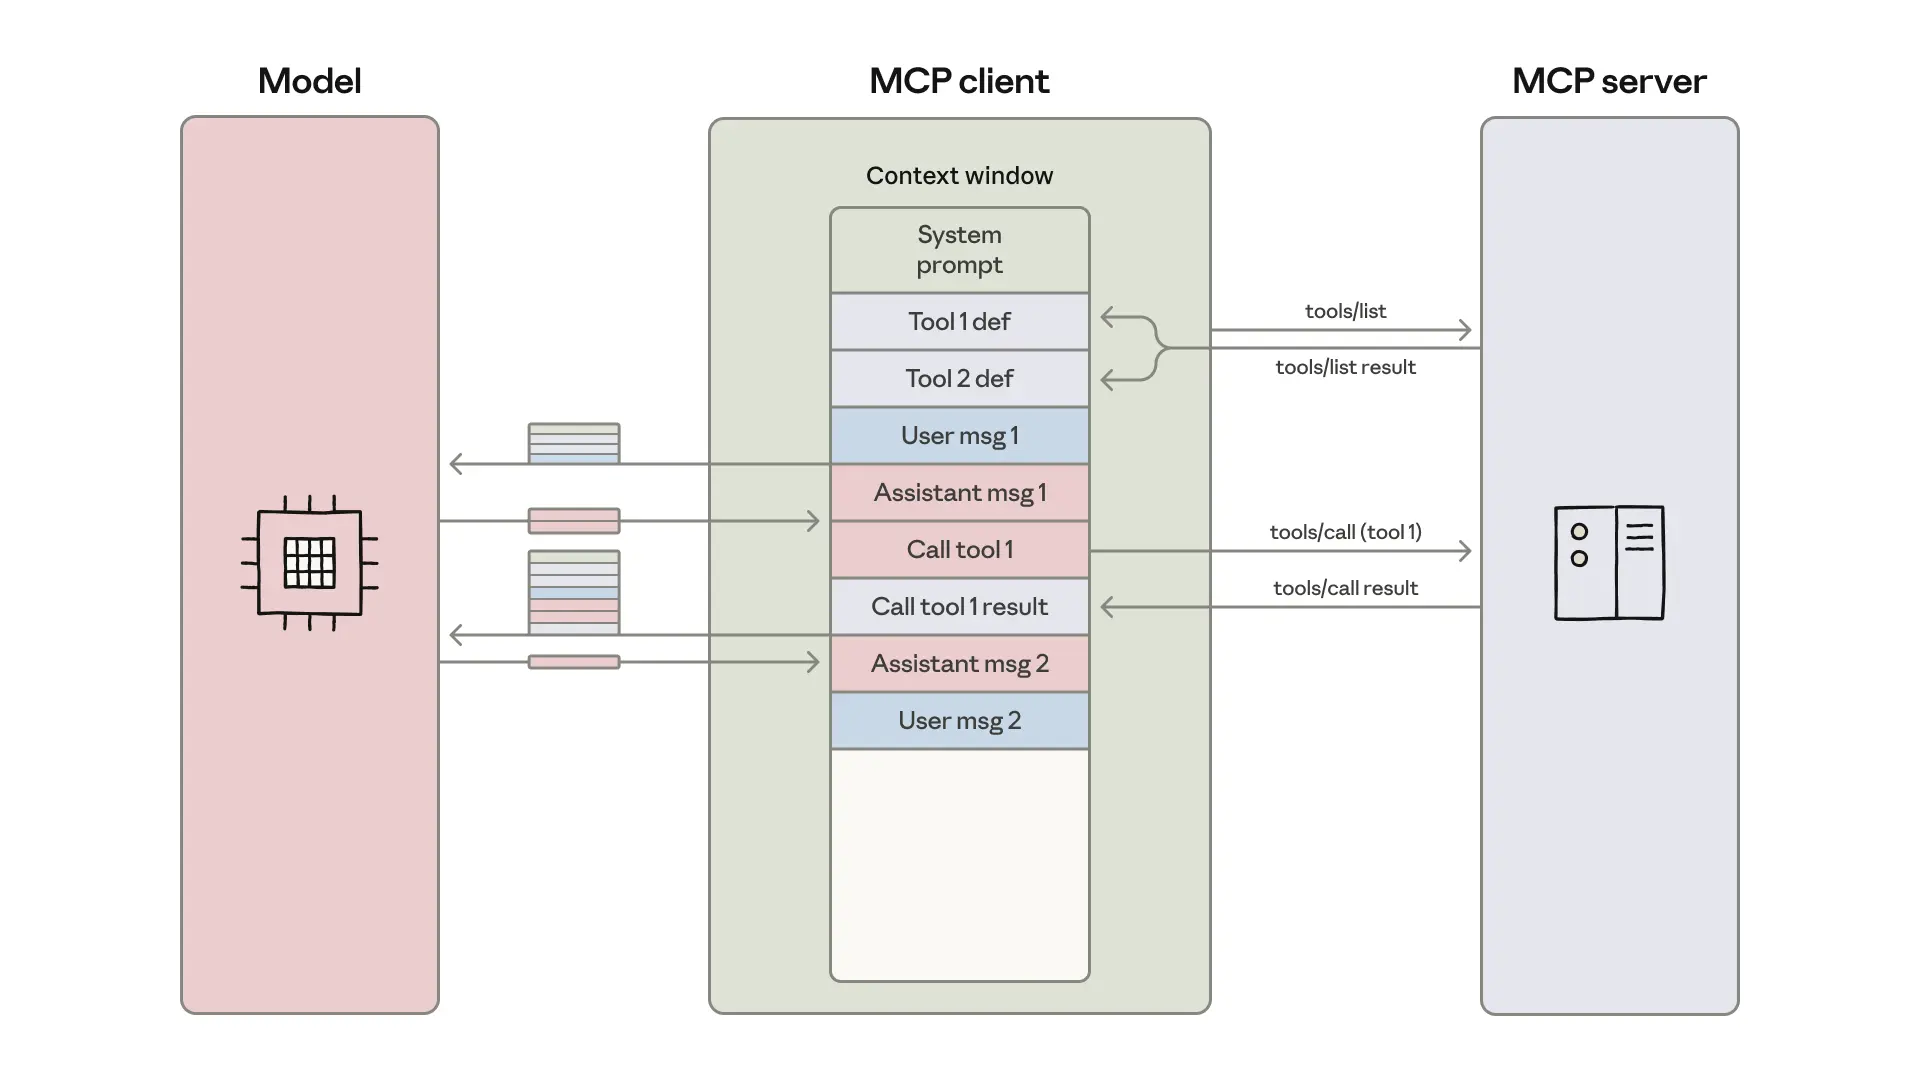
MCP 클라이언트는 도구 정의를 모델의 컨텍스트 윈도에 로드하고, 각 도구 호출과 결과가 작업 사이마다 모델을 통과하는 메시지 루프를 조율합니다.
MCP를 활용한 코드 실행은 컨텍스트 효율을 높입니다
에이전트를 위한 코드 실행 환경이 점점 더 보편화됨에 따라, 하나의 해결책은 MCP 서버를 직접적인 도구 호출이 아니라 코드 API로 제시하는 것입니다. 그러면 에이전트는 MCP 서버와 상호작용하기 위한 코드를 작성할 수 있습니다. 이 접근 방식은 두 가지 문제를 모두 해결합니다. 에이전트는 필요한 도구만 불러올 수 있고, 결과를 모델에 다시 전달하기 전에 실행 환경에서 데이터를 처리할 수 있습니다.
이를 수행하는 방법은 여러 가지가 있습니다. 한 가지 방법은 연결된 MCP 서버에서 사용 가능한 모든 도구의 파일 트리를 생성하는 것입니다. 다음은 TypeScript를 사용한 구현 예시입니다:
servers
├── google-drive
│ ├── getDocument.ts
│ ├── ... (other tools)
│ └── index.ts
├── salesforce
│ ├── updateRecord.ts
│ ├── ... (other tools)
│ └── index.ts
└── ... (other servers)그다음 각 도구는 다음과 같은 파일에 대응합니다:
// ./servers/google-drive/getDocument.ts
import { callMCPTool } from "../../../client.js";
interface GetDocumentInput {
documentId: string;
}
interface GetDocumentResponse {
content: string;
}
/* Read a document from Google Drive */
export async function getDocument(input: GetDocumentInput): Promise<GetDocumentResponse> {
return callMCPTool<GetDocumentResponse>('google_drive__get_document', input);
}위의 Google Drive에서 Salesforce로 보내는 예시는 다음 코드가 됩니다:
// Read transcript from Google Docs and add to Salesforce prospect
import * as gdrive from './servers/google-drive';
import * as salesforce from './servers/salesforce';
const transcript = (await gdrive.getDocument({ documentId: 'abc123' })).content;
await salesforce.updateRecord({
objectType: 'SalesMeeting',
recordId: '00Q5f000001abcXYZ',
data: { Notes: transcript }
});에이전트는 파일 시스템을 탐색해 도구를 발견합니다. ./servers/ 디렉터리를 나열해 사용할 수 있는 서버들(google-drive, salesforce 같은)을 찾고, 이어서 필요한 특정 도구 파일들(getDocument.ts, updateRecord.ts 같은)을 읽어 각 도구의 인터페이스를 이해합니다. 이렇게 하면 에이전트는 현재 작업에 필요한 정의만 불러올 수 있습니다. 이로 인해 토큰 사용량이 150,000개에서 2,000개로 줄어들어, 시간과 비용을 98.7% 절감할 수 있습니다..
Cloudflare는 유사한 발견을 게시했습니다. MCP를 이용한 코드 실행을 “Code Mode”라고 부르며 설명했습니다. 핵심 통찰은 같습니다. LLM은 코드를 작성하는 데 능숙하므로, 개발자는 이 강점을 활용해 MCP 서버와 더 효율적으로 상호작용하는 에이전트를 구축해야 합니다.
MCP를 이용한 코드 실행의 이점
MCP를 이용한 코드 실행은 도구를 필요할 때 불러오고, 모델에 도달하기 전에 데이터를 필터링하고, 복잡한 로직을 한 번에 실행함으로써 에이전트가 컨텍스트를 더 효율적으로 사용하게 해줍니다. 이 접근 방식에는 보안과 상태 관리 측면의 이점도 있습니다.
점진적 공개
모델은 파일 시스템을 탐색하는 데 매우 능숙합니다. 도구를 파일 시스템의 코드로 제시하면, 모델은 모든 도구 정의를 한꺼번에 읽는 대신 필요할 때마다 읽을 수 있습니다.
또는 서버에 search_tools 도구를 추가해 관련 정의를 찾을 수도 있습니다. 예를 들어, 위에서 사용한 가상의 Salesforce 서버를 다룰 때 에이전트는 “salesforce”를 검색하고 현재 작업에 필요한 도구만 불러옵니다. search_tools 도구에 세부 수준 매개변수를 포함해 에이전트가 필요한 상세 수준(예: 이름만, 이름과 설명, 또는 스키마가 포함된 전체 정의)을 선택할 수 있게 하면, 컨텍스트를 절약하고 도구를 더 효율적으로 찾는 데도 도움이 됩니다.
컨텍스트 효율적인 도구 결과
대용량 데이터셋을 다룰 때는 에이전트가 결과를 반환하기 전에 코드에서 필터링하고 변환할 수 있습니다. 10,000행 스프레드시트를 가져오는 상황을 생각해 보겠습니다:
// Without code execution - all rows flow through context
TOOL CALL: gdrive.getSheet(sheetId: 'abc123')
→ returns 10,000 rows in context to filter manually
// With code execution - filter in the execution environment
const allRows = await gdrive.getSheet({ sheetId: 'abc123' });
const pendingOrders = allRows.filter(row =>
row["Status"] === 'pending'
);
console.log(`Found ${pendingOrders.length} pending orders`);
console.log(pendingOrders.slice(0, 5)); // Only log first 5 for review에이전트는 10,000행이 아니라 5행만 보게 됩니다. 여러 데이터 소스를 가로지르는 집계, 조인, 특정 필드 추출에도 비슷한 패턴을 적용할 수 있으며, 이 모든 작업을 컨텍스트 윈도우를 부풀리지 않고 수행할 수 있습니다.
더 강력하고 컨텍스트 효율적인 제어 흐름
루프, 조건문, 오류 처리는 개별 도구 호출을 연쇄적으로 이어 붙이는 대신 익숙한 코드 패턴으로 처리할 수 있습니다. 예를 들어 Slack으로 배포 알림이 필요하다면, 에이전트는 다음과 같이 작성할 수 있습니다:
let found = false;
while (!found) {
const messages = await slack.getChannelHistory({ channel: 'C123456' });
found = messages.some(m => m.text.includes('deployment complete'));
if (!found) await new Promise(r => setTimeout(r, 5000));
}
console.log('Deployment notification received');이 방식은 에이전트 루프를 통해 MCP 도구 호출과 sleep 명령을 번갈아 실행하는 것보다 더 효율적입니다.
또한 실행되는 조건 분기 트리를 직접 작성할 수 있다는 점은 “첫 토큰까지의 시간” 지연도 줄여 줍니다. 모델이 if 문을 평가하기를 기다리는 대신, 에이전트는 코드 실행 환경이 이를 처리하게 할 수 있습니다.
개인정보를 보호하는 작업
에이전트가 MCP와 함께 코드 실행을 사용할 때, 중간 결과는 기본적으로 실행 환경 안에 남아 있습니다. 따라서 에이전트는 명시적으로 로그하거나 반환한 내용만 보게 되므로, 모델과 공유하고 싶지 않은 데이터도 모델의 컨텍스트에 들어가지 않은 채 워크플로를 통과할 수 있습니다.
더 민감한 작업에서는 에이전트 하니스가 민감한 데이터를 자동으로 토큰화할 수도 있습니다. 예를 들어 스프레드시트의 고객 연락처 정보를 Salesforce로 가져와야 한다고 가정해 보겠습니다. 에이전트는 다음과 같이 작성합니다:
const sheet = await gdrive.getSheet({ sheetId: 'abc123' });
for (const row of sheet.rows) {
await salesforce.updateRecord({
objectType: 'Lead',
recordId: row.salesforceId,
data: {
Email: row.email,
Phone: row.phone,
Name: row.name
}
});
}
console.log(`Updated ${sheet.rows.length} leads`);MCP 클라이언트는 데이터가 모델에 도달하기 전에 이를 가로채고 PII를 토큰화합니다:
// What the agent would see, if it logged the sheet.rows:
[
{ salesforceId: '00Q...', email: '[EMAIL_1]', phone: '[PHONE_1]', name: '[NAME_1]' },
{ salesforceId: '00Q...', email: '[EMAIL_2]', phone: '[PHONE_2]', name: '[NAME_2]' },
...
]그다음 다른 MCP 도구 호출에서 데이터가 공유될 때, MCP 클라이언트의 조회를 통해 다시 원래 값으로 복원됩니다. 실제 이메일 주소, 전화번호, 이름은 Google Sheets에서 Salesforce로 이동하지만, 모델을 거치지는 않습니다. 이를 통해 에이전트가 민감한 데이터를 실수로 기록하거나 처리하는 일을 막을 수 있습니다. 또한 이를 사용해 결정론적인 보안 규칙을 정의하고, 데이터가 어디로부터 어디로 흐를 수 있는지 선택할 수도 있습니다.
상태 지속성과 Skills
파일 시스템 접근이 가능한 코드 실행은 에이전트가 작업 전반에 걸쳐 상태를 유지할 수 있게 해줍니다. 에이전트는 중간 결과를 파일에 기록해 작업을 재개하고 진행 상황을 추적할 수 있습니다:
const leads = await salesforce.query({
query: 'SELECT Id, Email FROM Lead LIMIT 1000'
});
const csvData = leads.map(l => `${l.Id},${l.Email}`).join('\n');
await fs.writeFile('./workspace/leads.csv', csvData);
// Later execution picks up where it left off
const saved = await fs.readFile('./workspace/leads.csv', 'utf-8');에이전트는 자신의 코드를 재사용 가능한 함수로 보존할 수도 있습니다. 에이전트가 어떤 작업에 대해 동작하는 코드를 개발하면, 그 구현을 나중에 다시 사용할 수 있도록 저장할 수 있습니다:
// In ./skills/save-sheet-as-csv.ts
import * as gdrive from './servers/google-drive';
export async function saveSheetAsCsv(sheetId: string) {
const data = await gdrive.getSheet({ sheetId });
const csv = data.map(row => row.join(',')).join('\n');
await fs.writeFile(`./workspace/sheet-${sheetId}.csv`, csv);
return `./workspace/sheet-${sheetId}.csv`;
}
// Later, in any agent execution:
import { saveSheetAsCsv } from './skills/save-sheet-as-csv';
const csvPath = await saveSheetAsCsv('abc123');이는 Skills 개념과도 밀접하게 연결됩니다. Skills는 특화된 작업에서 모델의 성능을 높이기 위한 재사용 가능한 지침, 스크립트, 리소스의 폴더입니다. 이 저장된 함수에 SKILL.md 파일을 추가하면, 모델이 참조하고 사용할 수 있는 구조화된 skill이 만들어집니다. 시간이 지나면서 이는 에이전트가 더 높은 수준의 기능들로 이루어진 도구 상자를 구축하게 하고, 가장 효과적으로 작업할 수 있도록 필요한 기반 구조를 발전시켜 줍니다.
코드 실행에는 그 자체의 복잡성이 따릅니다. 에이전트가 생성한 코드를 실행하려면 적절한 샌드박싱, 자원 제한, 모니터링을 갖춘 안전한 실행 환경이 필요합니다. 이러한 인프라 요구사항은 직접적인 도구 호출에서는 필요 없는 운영상 부담과 보안 고려 사항을 추가합니다. 코드 실행의 이점인 토큰 비용 절감, 지연 시간 감소, 향상된 도구 조합성은 이러한 구현 비용과 비교해 따져봐야 합니다.
요약
MCP는 에이전트가 많은 도구와 시스템에 연결할 수 있게 해 주는 기반 프로토콜입니다. 그러나 연결된 서버가 너무 많아지면 도구 정의와 결과가 과도한 토큰을 차지하여 에이전트 효율이 떨어질 수 있습니다.
이곳의 많은 문제는 맥락 관리, 도구 조합, 상태 지속성처럼 새롭게 느껴지지만, 사실 소프트웨어 공학에서 이미 알려진 해결책이 있습니다. 코드 실행은 이러한 확립된 패턴을 에이전트에 적용하여, MCP 서버와 더 효율적으로 상호작용할 수 있도록 익숙한 프로그래밍 구조를 사용하게 합니다. 이 접근 방식을 구현한다면, 그 결과를 MCP 커뮤니티와 공유해 주시기 바랍니다.
출처
- 원문: https://www.anthropic.com/research/code-execution-with-mcp (2026-10-22 · anthropic.com)