
AI 에이전트로 Bruno API 테스트 컬렉션 만드는 법
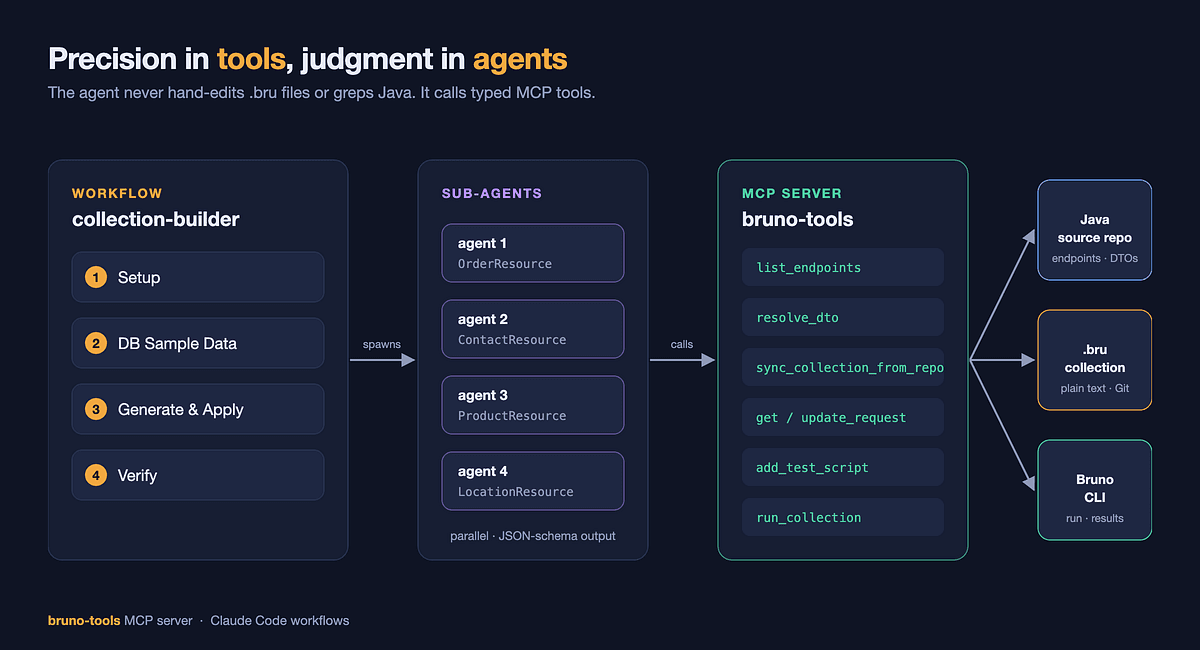
지루하고 정확해야 하는 부분은 사용자 정의 Bruno MCP 서버로, 판단이 필요한 부분은 멀티 에이전트 워크플로로 처리했다. 16개 서비스에 걸쳐 약 1,600개의 API 요청을 다뤄보니, 다음과 같은 점을 배웠다.
모든 QA 엔지니어는 이런 백로그 항목을 안다: “서비스 X에 대한 API 테스트를 작성하라.”
리포지토리를 열고, 리소스 클래스를 찾아서, 각 엔드포인트를 API 클라이언트에 복사한 뒤, 요청 본문을 추측하고, 데이터베이스에서 유효한 ID를 찾아내고, 상태 코드 어설션을 작성하고, 이 과정을 반복한다. 엔드포인트가 마흔 개쯤 지나면 반쯤만 동작하는 컬렉션이 생기고, 다음 스프린트가 되면 개발자들은 당신이 모르는 엔드포인트를 여섯 개나 더 추가해 둔다.
나는 API 테스트에 Bruno를 사용한다. Bruno는 오픈소스이며 Postman의 대안으로 Git 친화적인 도구로, 모든 요청을 코드 옆의 일반 텍스트 .bru 파일로 저장한다. 일반 텍스트라는 뜻은 AI 에이전트가 그것을 읽고 쓸 수 있다는 의미이므로, 이 작업의 얼마나 많은 부분을 Claude Code에 맡길 수 있을지 확인해 보기로 했다.
처음 시도는 순진했다: “여기 리포가 있으니 Bruno 컬렉션을 만들어 줘.” 결과는 좋지 않았다. 에이전트는 필드를 지어냈고, 상속된 DTO 속성을 놓쳤고, res를 가리는 테스트를 작성했으며, 서비스 내 모든 리소스에 같은 {{id}} 변수를 재사용했다.
마침내 잘 동작하게 만든 방법은 작업을 둘로 나누는 것이었다:
- 반드시 결정적이어야 하는 모든 것을 위한 MCP 서버: 소스 코드 파싱,
.bru파일 읽기와 쓰기, 컬렉션 실행. - 판단이 필요한 모든 것을 위한 워크플로(스크립트로 작성된 멀티 에이전트 파이프라인): 현실적인 값, 의미 있는 어설션, 올바른 예상 상태 코드.
이 글에서는 둘 다 살펴본다.

워크플로는 에이전트를 조율하고, 에이전트는 타입이 지정된 MCP 도구를 호출하며, 코드·파일·CLI를 직접 건드리는 것은 도구뿐이다.
1부: Bruno MCP 서버
MCP(Model Context Protocol)를 사용하면 AI 에이전트에 자기만의 도구를 줄 수 있다. 에이전트가 Java 파일을 grep 하고 .bru 텍스트를 손수 편집하게 두는 대신, 나는 bruno-tools라는 작은 TypeScript MCP 서버를 만들어 다음과 같은 타입 지정 작업을 노출했다:

bruno-tools MCP 서버: 결정적 단계마다 타입이 지정된 도구 하나씩
왜 그냥 프롬프트만 주는 대신 서버를 만들었을까?
LLM은 빠짐없이 처리하는 데 약하고, 파서는 그 일을 잘하기 때문이다.
가장 좋은 예가 resolve_dto다. 요청 DTO가 또 다른 기본 클래스를 상속한 기본 클래스를 상속하는 경우, 소스 파일을 읽는 에이전트는 거의 항상 필드를 하나 놓친다. 클래스 계층 구조를 따라가는 작은 Java 파서는 그런 실수를 하지 않는다. 그래서 이제 sync_collection_from_repo는 타입이 지정된 플레이스홀더를 가진 완전한 JSON 스켈레톤으로 요청 본문을 생성한다:
{ "name": "", "externalId": "", "active": false, "address": { "line1": "", "city": "", "zip": "" }, "type": "ENUM_VALUE"}이제 에이전트는 어떤 필드가 있는지 알아내느라 애쓸 필요가 없다. 에이전트의 유일한 임무는 그 안에 현실적인 값을 넣는 것이다. 그렇게 하면 LLM이 잘 못하는 회상 문제를, LLM이 잘하는 채우기 문제로 바꿀 수 있다.
resolve_dto는 상속된 필드를 포함해 모든 필드를 생성한다. 에이전트는 값만 넣으면 된다 이 서버는 또한 자신이 볼 수 없는 것을 정직하게 드러낸다. 어떤 필드의 타입이 리포에 없는 외부 라이브러리에서 오면, 동기화 결과는 추측하지 않고 그 필드를 unresolvedBodyFields 아래에 나열한다. 그러면 워크플로는 다음에 어디를 더 살펴봐야 하는지 정확히 알 수 있다.
드라이런으로 안전하게 만든다
sync_collection_from_repo는 dryRun: true를 받아, 실제로 무엇을 만들고, 건너뛰고, 애매하다고 표시할지 아무것도 건드리기 전에 보고한다. 에이전트는 이를 두 번 호출한다. 한 번은 살펴보기 위해, 한 번은 실행하기 위해서다. 그리고 나는 로그에서 그 계획을 읽을 수 있다.
2부: 워크플로
도구만으로는 충분하지 않다. 어떤 순서로 도구를 호출할지, 몇 개의 에이전트를 병렬로 돌릴지, 무엇을 “완료”로 볼지를 결정하는 무언가가 필요하다. 이를 위해 나는 Claude Code 워크플로를 사용한다. 즉, 각각 초점이 맞춰진 프롬프트와 엄격한 JSON 출력 스키마를 가진 여러 하위 에이전트를 조율하는 JavaScript 스크립트다.
나는 의도적으로 작업을 두 개의 워크플로로 나눴다.
Workflow 1: bruno-collection-builder: 생성만 하고, 실행은 하지 않기
입력: { service: "orders-api", env: "qa" }
이 워크플로는 네 단계로 실행된다:
- 설정. 대상 환경에서 클라우드 자격 증명이 유효한지 확인한 다음, 유효하지 않으면 즉시 중단합니다. (SSO 로그인은 대화형이므로, 자동화되지 않은 워크플로 안에서는 수행할 수 없습니다. 빨리 실패하면 낭비되는 토큰을 많이 줄일 수 있습니다.) 그런 다음 서비스를 등록하고,
sync_collection_from_repo를 실행한 뒤, 모든 엔드포인트를 해당.bru파일에 매핑합니다.
- DB 샘플 데이터. 연결 정보를 전달하면 에이전트가 읽기 전용 테스트 데이터베이스로 짧게 유지되는 터널을 엽니다. 엔드포인트가 제안하는 각 엔터티에 대해(예를 들어
/locations/{id}는locations테이블을 시사함), 실제 행 몇 개를 가져옵니다. 자격 증명은 바로 셸 변수로 들어가며 로그에는 절대 나타나지 않습니다. 연결 정보가 전달되지 않으면 이 단계는 실패가 불가피한 탐색에 토큰을 낭비하는 대신 스스로 건너뜁니다.
- 생성 및 적용. 이게 핵심입니다. 엔드포인트는 리소스 클래스별로 그룹화되고, 각 그룹은 자체 에이전트로 보내지며, 모두 병렬로 실행됩니다. 그룹화한다는 것은 각 엔드포인트마다
OrderResource.java를 한 번씩 읽는 것이 아니라, 에이전트 하나가 한 번만 읽는다는 뜻입니다. 각 에이전트는 실제 값을 채우고, chai assertion을 작성한 뒤, MCP 도구를 통해 변경 사항을 적용합니다.
- 검증. 마지막 에이전트가 전체 컬렉션의 커버리지 공백과 흔한 실수를 감사합니다.

한 번의 워크플로 실행: 인증 확인, 동기화, DB 샘플링, 리소스 클래스별 병렬 에이전트, 감사. (설명용 수치입니다.)
Workflow 2: bruno-collection-runner: 실행만 하고, 절대 수정하지 않음
입력: { service, env, target?, bail?, report? }
이 워크플로는 컬렉션(또는 하나의 폴더나 요청)을 환경에 대해 실행하고, 총계, 성공, 실패, 각 실패의 세부 정보를 포함한 구조화된 결과를 반환합니다. 선택적으로 HTML 보고서를 게시할 수도 있습니다.

러너는 실패를 보고합니다. 테스트를 통과시키기 위해 테스트를 절대 수정하지 않습니다. (설명용 수치입니다.) 왜 워크플로를 둘로 나눴을까요? 실패한 실행이 조용히 테스트를 “고쳐서” 통과시키게 해서는 안 되기 때문입니다. 생성과 실행을 분리해 두면, 빨간 테스트는 언제나 반드시 살펴봐야 하는 실제 신호가 됩니다.
Part 3: 에이전트에게 가르쳐야 했던 규칙들(가장 힘들게 얻은 부분)
저는 대부분의 시간을 실제 실패를 바탕으로 규칙을 만드는 데 쏟았습니다. 아래의 각 항목은 환경 문제처럼 보였지만, 사실은 생성된 컬렉션의 연결 오류였던 버그를 일으켰습니다.
1. 리소스 간에 그냥 {{id}}를 공유하지 말 것
가장 심각한 버그였습니다. 생성된 모든 요청이 {{id}}를 사용해서, "Get Contact by id"는 실제로 order의 ID를 보내고 있었습니다. 그 결과는 나쁜 테스트 데이터처럼 보이는 404, 400, 500의 뒤섞인 조합이었습니다.
규칙: 각 리소스에는 {{orderId}}, {{contactId}}, {{productId}}처럼 고유한 변수를 두고, 사용할 수 있다면 DB 샘플의 실제 값으로 초기화합니다.

같은 컬렉션, 같은 환경. 차이는 변수 이름뿐입니다.
2. void 엔드포인트는 200이 아니라 204를 반환한다
에이전트는 기본적으로 expect(res.status).to.equal(200)를 사용합니다. 하지만 void를 반환하는 JAX-RS 메서드는 204 No Content로 응답합니다.
규칙 : 기대하는 상태 코드를 선택하기 전에 Java 메서드 시그니처를 읽으세요.
3. 필수 쿼리 파라미터는 반드시 있어야 한다
@NotNull @QueryParam("searchString")가 붙은 검색 엔드포인트는 쿼리 문자열 없이 호출되면 400을 반환합니다. 에이전트는 절대 성공할 수 없는 "전체 조회" 요청을 보내는 것을 좋아했습니다.
규칙 : 모든 @QueryParam을 나열하고, 검증 대상인 것들은 항상 그럴듯한 값과 함께 포함하세요.
4. 생성 엔드포인트는 재실행 가능해야 한다
첫 번째 실행에서는 externalId: "PO-1001"가 생성됩니다. 두 번째 실행에서는 409 Conflict로 실패합니다.
규칙: 소스가 어떤 필드의 고유성을 검사한다면, 다음처럼 실행마다 다른 접미사를 붙이세요:
// collection.bru (pre-request script)bru.setVar("runSuffix", Date.now() % 1000000);{ "externalId": "PO-1001-{{runSuffix}}" }그다음 테스트에서 같은 값을 다시 읽습니다:
expect(res.body.externalId) .to.equal('PO-1001-' + bru.getVar('runSuffix'));
실행마다 다른 접미사를 붙이면 생성 엔드포인트를 안전하게 다시 실행할 수 있습니다.
5. 이미 잘 된 작업은 건너뛴다
재실행 시 에이전트는 각 요청을 먼저 확인합니다. 이미 실제 assertion이 있고, 플레이스홀더 값이 없으며, 규칙 1~4를 통과하면 에이전트는 그대로 둡니다. 그렇게 하니 재실행 비용이 훨씬 줄었고, 이미 잘 동작하던 테스트를 에이전트가 다시 쓰는 일도 멈췄습니다.
6. 에이전트 자신의 테스트 코드를 sanity-check 하라
이런 문제들은 당연해 보이지만, 실제로는 모두 일어났습니다: const res = ...가 Bruno의 res를 가리는 문제, Postman의 pm. API가 Bruno 스크립트에 섞여 들어가는 문제, 그리고 실제 줄바꿈이 있어야 할 곳에 리터럴 \n 텍스트가 들어가는 문제였습니다. 이제 각 에이전트는 저장하기 전에 자기 자신의 testsJs를 린트합니다.
제가 직접 해보려는 분께 말씀드리고 싶은 것
- 결정론적인 작업은 도구 뒤에 두세요. 하나의 정답만 있는 작업이라면(파싱, 파일 형식, CLI 실행 등) 모델이 임의로 처리하게 두지 마세요.
- 각 에이전트의 출력에 대해 JSON 스키마를 하나씩 주세요. 구조화된 결과가 있으면 워크플로가 분기, 재시도, 보고를 할 때 산문을 파싱할 필요가 없습니다.
- 사전조건은 빨리 실패하게 하세요. 인증 확인과 “할 일이 있는가?” 확인은 몇 초 안에 실행을 끝내야 합니다.
- 빌드와 실행을 분리하세요. 테스트 러너가 자기 자신의 테스트를 편집해서는 안 됩니다.
- 모든 버그를 규칙으로 바꾸세요. 제 프롬프트가 긴 이유는 각 문단이 다시 보고 싶지 않은 버그이기 때문입니다.
- 읽기 전용 데이터는 항상 읽기 전용으로 두세요. 에이전트는 데이터베이스에서 샘플을 읽을 뿐, 절대 쓰지 않습니다.
Bruno의 일반 텍스트 형식은 이 작업에서 결국 가장 큰 장점이었습니다. 사람이 Git diff에서 검토할 수 있는 내용이라면, 에이전트도 안전하게 쓸 수 있습니다. 여기에 정확성을 위한 MCP 서버와 오케스트레이션을 위한 워크플로를 결합하면, API 테스트 커버리지는 더 이상 백로그 항목으로 남지 않습니다.
Bruno, MCP, 또는 Claude Code 워크플로로 비슷한 것을 만들고 계시다면, 경험을 나누고 싶습니다. 댓글을 남겨 주세요.
출처
- 원문: https://medium.com/@khan.aatif2807/i-let-an-ai-agent-build-my-api-test-collections-heres-the-setup-that-made-it-actually-work-751678bb01f6?source=rss------claude_code-5 (2026-10-16 · Mohd Aatif Khan)