
Claude Fable 5.1·Mythos 5.1 발표

저희는 Claude Fable 5.1과 Claude Mythos 5.1을 소개합니다. 이들은 코딩과 지식 작업을 위한 세계에서 가장 진보한 모델이며, 연구 역량은 AI 모델이 과학적 진보에 어떻게 기여할지에 대한 초기 모습을 보여줍니다.
Claude Fable 5.1과 Claude Mythos 5.1은 같은 모델이지만, 안전장치 수준이 다릅니다. Fable 5.1은 일반적으로 사용할 수 있는 반면, Mythos 5.1은 신뢰할 수 있는 접근 프로그램을 통해서만 제공됩니다. Mythos 5.1의 안전장치는 사이버보안과 생명과학 분야의 작업을 지원하도록 특별히 설계되었습니다.
향상된 기능과 함께, Fable 5.1은 가격, 데이터 보존, 안전장치에 대해 고객들로부터 받은 피드백을 해결하기 위한 중요한 조치를 취합니다.
가격. Fable 5.1은 토큰 기준으로 사용량이 과금되는 경우, 일반적인 워크로드에서 Fable 5보다 예상 약 25% 저렴합니다. 이는 캐시 읽기(모델이 이미 처리되어 저장된 입력을 읽는 작업)에 대한 가격을 낮추기 때문입니다. 에이전트 기반 작업이 매우 강한 경우에는 절감 폭이 훨씬 더 커져, 최대 약 45%까지 될 수 있습니다.
데이터 보존. 저희의 새로운 Enterprise Frontier Safeguards(EFS) 시스템은 고객에게 완전한 개인정보 보호(제로 데이터 보존 정책과 동일한 수준)를 제공하면서도, 악의적 사용을 방지하는 면에서는 여전히 최첨단 수준을 유지합니다. EFS는 Anthropic이 아닌 고객이 완전히 통제하는 클라우드 인프라에 데이터를 저장하는 방식으로 작동합니다. 이는 이번 가을 후반부터 시작해 단계적으로 기업 고객에게 제공될 예정입니다. EFS를 사용할 수 있게 되기 전까지는, 자격이 있는 고객이 Fable 5.1을 제로 데이터 보존으로 사용할 수 있습니다.
안전장치. 저희는 오탐지(시스템이 무해한 콘텐츠를 위험하다고 표시하는 경우)를 줄이기 위해 안전장치를 개선했습니다. 사이버보안에서는 최신 안전장치가 이전보다 60% 적은 오탐지를 차단합니다. 이는 부분적으로 Fable 5.1을 이제 소프트웨어 취약점을 발견하는 데 사용할 수 있기 때문인데, 그 취약점을 악용하는 익스플로잇을 개발하는 데 사용할 수는 없습니다. 생물학 분야에서는 미국 정부와의 협력을 통해 개발된 접근 프로그램을 마련하여 Claude Mythos 5.1의 고급 생물학 기능에 접근할 수 있도록 했습니다. 곧 과학자 대상 등록을 시작할 것으로 예상합니다.
새로운 성능의 최전선
Claude Fable 5.1은 코딩, 지식 작업, 장시간 문제 해결 작업에서 새로운 기준을 세웁니다. 아래 차트는 Fable 5.1이 이전 모델인 Fable 5보다 훨씬 높은 성능을 낼 수 있음을 보여줍니다. 또한 Low 또는 Medium effort로 설정하면, Fable 5.1은 훨씬 더 낮은 비용으로 Fable 5와 비슷하거나 더 나은 결과를 달성합니다. (Claude Code에서는 Fable 5.1이 기본적으로 High effort이며, Claude Cowork와 Claude.ai에서는 Medium이 기본값입니다.)
에이전트 기반 과학 연구
Terminal-Bench-Science 0.1 정확도 vs 비용
Terminal-Bench-Science 0.1: 표준 오차는 모델당 ±3.5–4.5포인트입니다. 공개 리더보드(작업당 3회 시도, Claude Code harness)는 Claude Opus 5를 30.0%, Claude Fable 5를 21.4%로 보고했으며, 저희 설정에서는 각각 29.0%와 24.7%로 재현되어, 둘 다 잡음 범위 안에 있습니다.
에이전트 기반 터미널 코딩
Terminal-Bench 4.0 정확도 vs 비용
Terminal-Bench 4.0은 각 effort 수준에서 비용 대비 성능(로그 스케일)으로 표시됩니다. Claude Fable 5.1과 Claude Mythos 5.1은 같은 기반 모델이며, 둘 사이의 차이는 이전의 덜 정밀한 사이버 안전장치가 개입한 작업들에서 비롯됩니다. 오늘 저희가 이러한 안전장치를 개선함에 따라, 두 모델 간 차이는 훨씬 더 작아질 것으로 예상합니다.
다분야 추론
Humanity's Last Exam 정확도 vs 비용
Humanity’s Last Exam은 각 effort 수준에서 비용 대비 성능(로그 스케일)으로 표시됩니다. CursorBench 3.2.0은 각 effort 수준에서 비용 대비 성능(로그 스케일)으로 표시됩니다.
에이전트 기반 코딩
CursorBench 3.2.0 정확도 vs 비용
CursorBench 3.2.0은 각 effort 수준에서 비용 대비 성능(로그 스케일)으로 표시됩니다.
Fable 5.1은 더 낮은 품질의 결과로 이어지는 지름길을 피하며, 소프트웨어 문제의 근본 원인을 고칠 만큼 똑똑합니다. 예를 들어, 투자회사 Millennium의 테스트에서 Fable 5.1은 내부 시스템에서 드물게 발생하던 크래시의 원인을 찾아냈는데, 그 문제는 여러 해 동안 시도했음에도 엔지니어들(이나 다른 어떤 모델도) 설명하지 못했던 것이었습니다.
여기에서 Fable 5.1이 다양한 벤치마크에서 어떻게 비교되는지 확인할 수 있습니다:
| Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol | |
|---|---|---|---|---|
| 에이전트형 과학 연구 Terminal-Bench-Science 0.1 [1] | 52.6% | 24.7% | 29.0% | 22.4% |
| 에이전트형 코딩 Terminal-Bench 4.0 | 55.8%60.9% (Mythos 5.1) | 42.0% | 52.3% | 37.3% |
| 지식 작업 GDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| 컴퓨터 사용 OSWorld 2.0 [2] | 77.9%부분적 | 72.9%부분적 | 75.4%부분적 | — |
| 컴퓨터 사용 OSWorld 2.0 | 41.7%엄격 | 36.1%엄격 | 39.6%엄격 | — |
| 다학제 추론 Humanity's Last Exam | 60.9%도구 없음 | 57.8%도구 없음 | 56.6%도구 없음 | — |
| 다학제 추론 Humanity's Last Exam | 65.0%도구 사용 | 63.8%도구 사용 | 63.6%도구 사용 | — |
| 비즈니스 워크플로 AutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| 에이전트형 코딩 CursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | 67.2% |
Fable 5.1은 프로덕션 안전장치를 활성화한 상태로 평가되었습니다. 이러한 안전장치가 개입한 작업에서는 Fable 5.1과 Fable 5가 OSWorld 2.0에서 0점을 받았고, Fable 5는 AutomationBench에서 0점을 받았습니다. 안전장치의 다른 모든 개입에서는 사이버보안 작업은 Claude Opus 4.8이 완료했고, 생물학 작업은 Claude Opus 5가 완료했습니다. 이로 인해 이러한 벤치마크에서 Fable 5.1과 Fable 5의 성능이 낮아졌을 가능성이 큽니다.
초기 액세스 파트너들은 이러한 성능 향상을 알아챘고, 모델 출력의 보다 질적인 개선도 포착했습니다. 그들이 우리에게 전한 내용은 다음과 같습니다:
Jane Street Capital
Quote
“내부 벤치마크에서 Claude Fable 5.1은 Fable 5나 Opus 5보다 더 많은 코딩 문제를 해결했고, 트레이딩 직관에서는 최고 수준의 성능을 달성했습니다. 이전 모델들은 오래 작업할수록 따라가기 어려워졌지만, Fable 5.1은 긴 다단계 작업에서도 읽기 쉽게 유지됩니다.”
Company Jane Street Capital
Author Craig Falls, Head of Quantitative Research
Cognition
Quote
“출시 당일에 Devin에서 돌리던 Opus 5 트래픽을 Claude Fable 5.1로 옮길 예정입니다. 테스트에서는 Fable 5와 대체로 같거나 더 나은 성능을 보였고, 작업당 비용은 더 낮았으며, 새로운 캐시 읽기 가격 덕분에 마침내 Fable급 모델이 코드 리뷰를 시작으로 지금까지 Opus에 맡겨 두었던 워크로드에 대해 경제적으로도 맞아떨어지게 되었습니다.”
Company Cognition
Author Walden Yan, Co-founder and CPO
Millennium
Quote
“특정 코드 조각에 극도로 희귀한 크래시가 있었는데, 약 백만 번 실행 중 한 번 정도 발생하는 수준이어서 우리 팀 누구도 4~5년 동안 설명하지 못했습니다. Fable 5를 포함해 제가 시도해 본 모든 모델이 이를 놓쳤습니다. Claude Fable 5.1이 처음으로 그것을 찾아냈습니다. 외부 벤더 라이브러리를 디스어셈블하고, 이를 코어 덤프와 대조해 보았으며, 결국 크래시 원인을 그 라이브러리의 버그로 추적했습니다. 그 분석에 들었을 시간을 정당화하기는 어렵습니다.”
Company Millennium
Author Damien, Senior Portfolio Manager
MongoDB
Quote
“Claude Fable 5.1은 약 3일 만에 복잡한 프로토타입을 구축했습니다. 우리 서비스 전반의 코드와 문서를 대상으로 초기 조사를 수행해 새롭고 확장 가능한 설계를 만들어 냈습니다. 그다음 강력한 검증 루프를 돌리며 몇 시간 동안 무인으로 실행되어 전체 프로토타입을 구현했습니다. 아침에 일어나면 다음 단계가 끝나 있었고, 그것이 만들어 낸 결과를 완전히 시각적으로 확인할 수 있었으며, 성공의 명확한 증거도 함께 있었습니다.”
Company MongoDB
Author Ron Sanzone, Staff Software Engineer
Every
Quote
“친근한 Fable입니다. Fable 수준의 지능, Opus 수준의 가격, Sonnet 속도. 저희 테스트에서는 Opus 5보다 약 두 배 빠르고 토큰도 절반만 사용했기 때문에, Opus를 일상용 주력 모델로 써 온 사람이라면 분명한 업그레이드입니다.”
Company Every
Author Dan Shipper, CEO
IMC
Quote
“우리 연구 스위트에서 Claude Fable 5.1은 새로운 최고 점수를 세웠습니다. 어떤 작업에서는 이전에 다른 모델이나 인간 연구자들에게서 보지 못한 완전히 다른 축의 새로운 해법을 떠올려, 결과가 이전의 정체 구간을 훌쩍 뛰어넘었습니다. 이 모델은 창의적인 문제 해결과, 어려운 문제를 풀기 위해 필요한 그 ‘번뜩임’을 얻는 데 더 뛰어납니다.”
Company IMC
Author Marquis Wong, Principal AI Engineer
Red Hat
Quote
“AI 모델에 대한 지속적인 평가의 일환으로, Claude Fable 5.1은 저희 테스트에서 인상적인 결과를 보여주었습니다. Claude Code를 사용해, 모든 난이도 수준에 걸쳐 테스트한 모든 깨진 빌드의 근본 원인을 정확히 찾아냈습니다. 또한 이전 Anthropic 모델들보다 더 간결하고 따라가기 쉬운 업데이트로 더 효과적으로 소통합니다.”
Company Red Hat
Author Josh Boyer, Distinguished Engineer
Rakuten
Quote
“저희는 Claude Fable 5.1에게 Rakuten Medical의 임상 연구 프로젝트를 검토해 달라고 요청했는데, 이 프로젝트는 다른 최첨단 모델 세 개가 모두 승인한 것이었습니다. 그런데 이 모델은 그들 누구도 보지 못한 빈틈을 찾아내고, 더 테스트해 보자고 강하게 주장했습니다. 이어서 완전히 새로운 가설을 제안했고, 저희가 이미 포기했던 데이터셋을 어느 한 오후에 새로운 연구 방향으로 바꿔 놓았습니다. Claude 같은 최첨단 모델이 이런 방식으로 새로운 연구를 탐색하도록 우리를 도와준 것은 이번이 처음입니다.”
Company Rakuten
Author Felix Giovanni Virgo, Principal AI Engineer
Square (Block)
Quote
“Claude Fable 5.1은 매우 똑똑합니다. 모델이 시뮬레이션된 Square 도구, 고객, 직원, 공급업체에 완전한 접근 권한을 가진 30일짜리 시뮬레이션 사업 운영 평가에서, 토큰당 효율이 Opus 5보다 훨씬 높았습니다. 우리는 이 모델을 사용해 가장 복잡한 시나리오들, 즉 예전에는 화이트보드 앞에서 며칠이 걸리던 종류의 문제를 해결할 계획입니다. 그래서 우리 엔지니어링 팀이 계속 빠르게 움직일 수 있습니다.”
Company Square (Block)
Author Willem Avé, Global Head of Product
Ramp
Quote
“연구, 그린필드, 또는 장기 프로젝트라면, 저는 주저 없이 Claude Fable 5.1을 오케스트레이터로 사용할 것입니다. 머신러닝 문제에서 사람이 붙지 않은 38시간짜리 실행 하나가 이전 결과를 라벨 아티팩트로 진단하고, 수정을 적용한 뒤, 밤새 돌아간 6개의 병렬 실험을 시작했고, 결과와 다음 단계를 가져왔습니다. 아무도 소유하지 않은 가장 레버리지가 큰 문제를 찾으라는 열린 프롬프트를 주었을 때는, 프로덕션 장애와 연결된 미소유 알림을 찾아내고, 로그를 가져와 수정 방법을 제시했습니다.”
Company Ramp
Author Dwight Temple, Sr. Machine Learning Engineer
Canva
Quote
“Claude Fable 5.1에서 가장 두드러지는 점은 글쓰기입니다. 더 이해하기 쉽고, 더 의미가 분명하며, 우리의 글쓰기 가이드를 더 잘 따릅니다. Fable 5와의 블라인드 테스트에서도 저는 글쓰기와 결과물을 더 선호했습니다. 그리고 Canva Code에서는 실제 음악과 박자에 맞는 게임 플레이가 있는 리듬 게임을, 생성한 레벨에 맞춰 구축했는데, 우리가 테스트한 다른 어떤 모델도 그런 결과를 내지 못했습니다.”
Company Canva
Author Danny Wu, Head of AI
Hebbia
Quote
“우리의 PowerPoint 평가에서 Claude Fable 5.1은 슬라이드 완성도와 연구 주제를 완전히 답하는 능력 모두에서, 우리가 테스트한 어떤 모델보다도 최고의 덱을 만들어 냈습니다. 같은 완성도는 Citations 평가에서도 드러났는데, 금융 문서에 대한 사실 회상 능력이 가장 좋았습니다. 그리고 복잡한 다중 파트 질문에서는, 우리가 본 첫 번째로 모든 부분에 답하는 모델입니다.”
Company Hebbia
Author Aabhas Sharma, CTO
Plaid
Quote
“세 개의 코드베이스에 걸친 8개 이상의 서비스를 건드리는 변경이 있었습니다. Claude Fable 5.1은 들어오는 서비스 호출부터 개별 함수, 데이터베이스 테이블과 행까지, 전체 워크플로를 끝에서 끝까지 극도로 세밀하게 매핑했고, 그 모든 부분이 끝까지 정확했습니다. 모델을 테스트하고 피드백을 제공할 기회를 얻어 감사했습니다. 이를 통해 우리는 점점 더 이 도구들에 의지해 더 대담한 이니셔티브를 맡길 수 있는 새로운 국면에 대비할 수 있었습니다.”
Company Plaid
Author Aditya Gupta, Staff Software Engineer
Glean
Quote
“우리의 평가 세트 전반에서, 심사위원들은 일상적 지식 질문, 높은 의도의 연구, 초안 작성 및 아티팩트 작업에서 Claude Fable 5.1의 답변을 Fable 5보다 대략 2대1로 더 선호했습니다. 또한 응답의 근거 제시도 Fable보다 개선되었습니다. 이 결과로 Fable 5.1은 이제 Fable 5가 이전에 선택되던 모든 곳에서 우리의 기본 추천 모델이 되었습니다.”
Company Glean
Author Nilesh Dalvi, Engineering Lead
iGent
Quote
“우리가 다루는 가장 어려운 문제들에서, Claude Fable 5.1은 우리가 시도해 본 어떤 다른 모델과도 확실히 구분됩니다. 18개월 동안 테스트베드로 사용해 온 그랜드 챌린지급 문제에서 실제로 의미 있는 진전을 만들어냈습니다. 단순히 우표 수집에 머무르는 대신, 제가 다른 곳에서는 아직 보지 못한 명확한 화이트스페이스 연결을 만들어냈습니다. 또한 Fable 5가 약 35%에서 한계를 보인 컴퓨트 커널을 최적화했습니다.”
Company iGent
Author Sean Ward, Co-founder and CEO
Browserbase
Quote
“가장 어려운 브라우저 에이전트 벤치마크에서 Claude Fable 5.1은 과제의 82%를 각각 약 10분 만에 완료했으며, Opus 5의 74%와 Fable 5의 57%를 앞섰고, 토큰 사용량은 둘보다 적었습니다. 우리가 시험하는 모든 차원에서 Fable 5보다 더 강력하게 느껴집니다. 또한 정확히 필요한 만큼만 일했습니다. 수백 개의 측정된 작업에서 한 번도 중요한 중단 지점을 넘지 않았습니다.”
Company Browserbase
Author Miguel Gonzalez, Technical Lead
Rogo
Quote
“우리의 내부 Finance 벤치마크에서 Claude Fable 5.1은 정확도 면에서 Fable 5와 같으면서도 토큰은 20% 적게 사용했습니다. 또한 슬라이드 생성에서도 큰 향상을 보였는데, Fable 5.1은 복잡한 데이터를 더 쉬운 영어로 설명하고 이를 더 은행가 수준의 시각 자료로 변환하는 데 개선을 보여주었습니다.”
Company Rogo
Author Alex Wang, Applied AI
Shopify
Quote
“Claude Fable 5.1은 Fable 5보다 긴 시간 동안 사람의 개입 없이 작업하는 데 더 익숙합니다. 저는 작업 흐름이 꽤 오랫동안 이어져도 맥락을 잃지 않는 경험을 했습니다. 자체 기록을 유지하고, 상황이 바뀌면 우선순위를 다시 조정하며, 중단된 지점에서 다시 이어서 진행합니다.”
Company Shopify
Author Ben Lafferty, Senior Staff Engineer
Crosby
인용
“Fable 5와 비교했을 때, Claude Fable 5.1은 당사의 계약서 레드라인 벤치마크인 RedlineBench에서 엄청난 개선을 보였으며, 47.9에서 57.0으로 향상되었습니다. 대부분의 향상은 첫 번째 턴의 품질에서 나왔는데, 이전 점수를 두 배로 끌어올렸고 상대방의 수용도에서도 상당한 향상이 있었습니다. 문서에 가한 수정도 더 간결해져 평균적으로 변경 폭이 더 작았습니다.”
회사 Crosby
Author Raymond Lin, Member of Technical Staff
Datadog
인용
“Claude Fable 5.1은 실제 프로덕션 사고를 사용해 에이전트 Bits Investigation이 얼마나 효과적으로 근본 원인 분석을 수행할 수 있는지 평가하는 당사의 사고 조사 평가에서 선도적인 모델입니다. 우리는 에이전트의 출력과 엔지니어가 식별한 근본 원인을 비교해 평가합니다. 이러한 평가에서 Opus 5보다 더 강한 추론 능력을 보여 주었고, 지금까지 테스트한 가장 복잡한 프로덕션 사고도 성공적으로 진단했습니다.”
회사 Datadog
Author Daniel Shan, Staff Engineer
SpaceXAI
인용
“Claude Fable 5.1은 CursorBench 3.2에서 우리가 실행해 본 모델 중 가장 뛰어난 성능을 보였고, 최대 노력 기준으로 73.4%를 기록했습니다. 특히 자기 작업을 검증하는 능력이 뛰어나다는 점을 확인했으며, 이를 통해 어려운 코딩 작업을 처음부터 끝까지 수행할 수 있었습니다.”
회사 SpaceXAI
Author Sualeh Asif, Director of ML
Samaya
인용
“우리는 실제 투자자 워크플로우를 바탕으로 모델과 시스템을 평가합니다. 최신 금융 벤치마크인 FrontierFinance에서 Claude Fable 5.1은 Fable 5보다 분명한 향상을 보여 주었으며, 49.2% 대비 55.9%의 루브릭 점수를 기록했습니다. 이 향상은 근거가 있고 권위 있는 출처를 더 집요하게 파고드는 능력에서 비롯됩니다. 한 수익 발표 관련 질문에서는 다른 모델들이 2차 보도에 기대는 동안, 직접 실적 발표 녹취록으로 가서 경영진이 언급한 정확한 수치를 포착했습니다.”
Company Samaya
Author Yuhao Zhang, Research Lead
과학 연구
우리는 다양한 분야에 걸쳐 Claude Fable 5.1과 Claude Mythos 5.1의 과학 연구 역량을 테스트했습니다. 아래에서 공유하는 초기 사례들을 포함해 우리가 발견한 바는 AI 모델이 머지않아 과학적 발견에 중요한 기여를 하게 될 것이라는 증거를 더해 줍니다.
분자 설계.많은 현대 의약품은 신체 내부의 표적에 결합해 무언가를 차단하거나 활성화하거나 전달하는 방식으로 작동합니다. 높은 결합 친화도를 가진 결합체는 약물이 더 낮은 용량에서도 작동하려면 필요하며, 이를 설계하는 것은 많은 일반적인 약물 유형의 개발 과정에서 첫 단계입니다. Claude Mythos 5.1이 이 과제를 얼마나 잘 수행할 수 있는지 알아보기 위해, 우리는 모델에 오픈소스 단백질 설계 및 접힘 도구에 대한 접근 권한을 주고 그 설계안을 두 개의 외부 기관에 보내 실험적으로 검증했습니다. Mythos 5.1은 매우 높은 결합 친화도를 가진 결합체를 설계할 수 있음이 입증되었습니다. 세 개의 표적에서, [3] 그 결합 친화도는 Adaptyv Bio의 단백질 설계 대회에 제출된 최선의 설계보다 10배 높았습니다. 적중률(즉, 실제로 유효한 결합체였던 설계의 수)은 지금까지 우리가 측정한 것 중 가장 높았으며, 12개 표적에서 거의 50%에 도달했습니다. (오늘날 단백질 설계에서 일반적인 적중률은 10~15%입니다.)
▶ 영상: https://cdn.sanity.io/files/4zrzovbb/website/dd1483b60a862b1acb3ed4359631ec99653a84c7.webm
각 12개 표적(회색)에 대한 Claude가 설계한 단백질 결합체(주황색). 영상에 나온 모든 설계는 실험실에서 결합이 확인되었습니다. 표시된 구조는 ESMFold2 예측 결과입니다.
계산 분석 및 모델링. Claude Fable 5.1은 신경망을 학습시켜 금성 표면의 3분의 1에 대한 새롭고 고해상도인 고도 지도를 만들었습니다. 이 작업은 NASA의 Magellan 임무가 30여 년 전에 촬영한 레이더 이미지와 이미 행성의 5분의 1에 대해 존재하던 지도를 기반으로 했습니다. Claude가 만든 새 지도는 이제 10~20킬로미터가 아니라 2~3킬로미터 수준의 세부 정보를 드러내며, 높이를 이전보다 최대 25% 더 정확하게 보여 줍니다.
우리는 다가오는 NASA VERITAS 및 ESA EnVision 임무에 앞서, 미래 관측에서 어떤 지질학적 특징을 목표로 삼아야 할지 결정하는 데 도움이 되기를 바라며 이 지도를 Creative Commons 라이선스로 공개합니다.
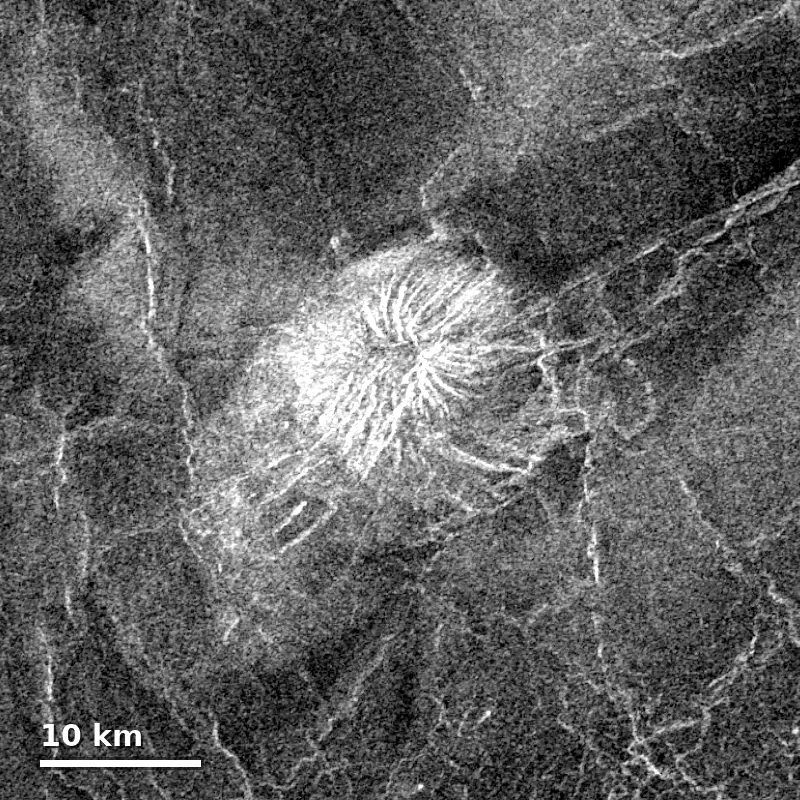
Magellan 레이더
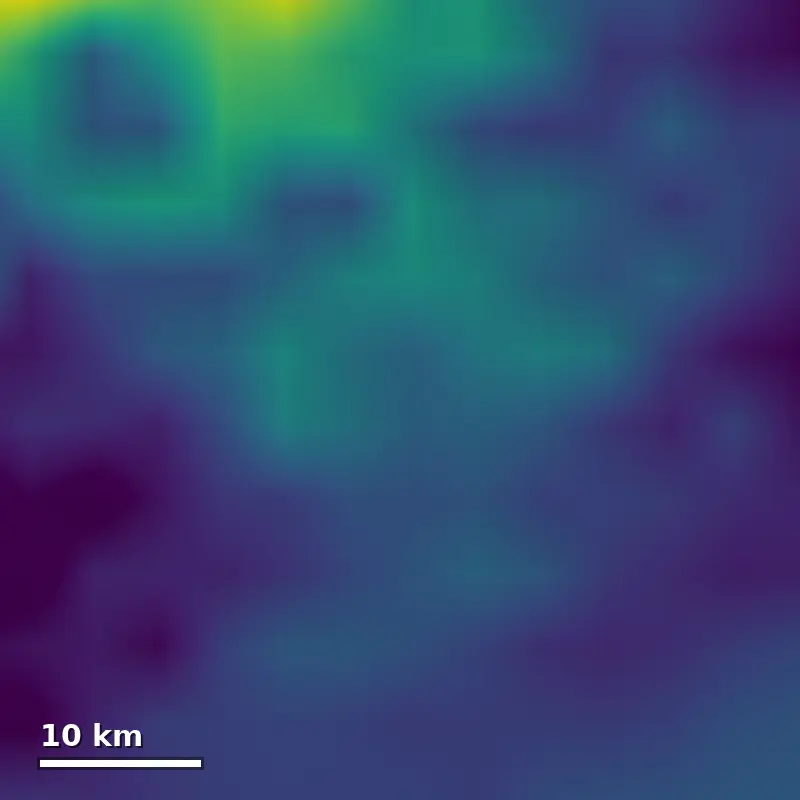
고도계 10~20km 범위
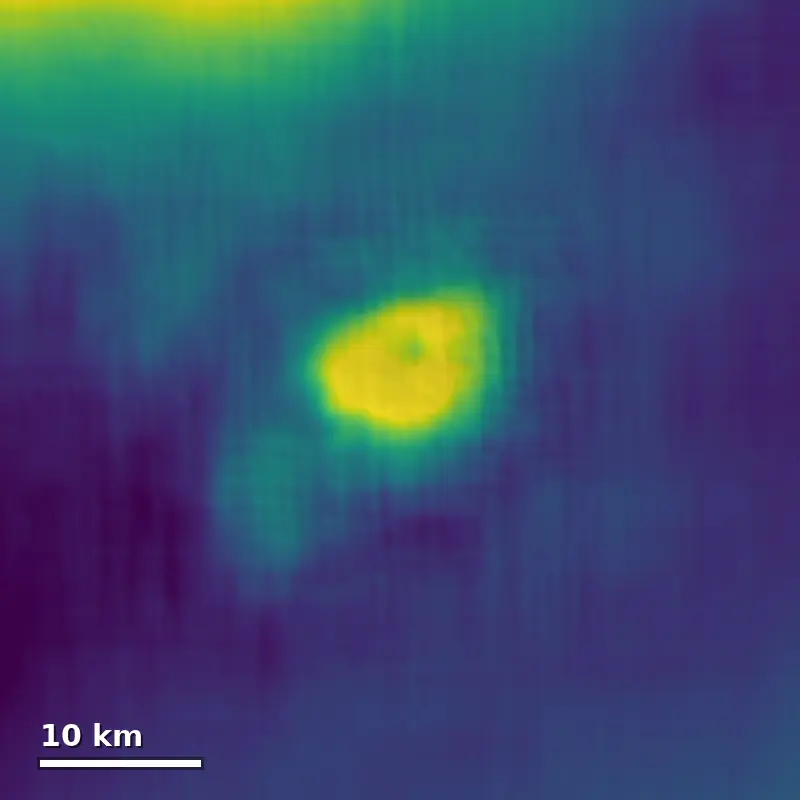
새로운 DEM(300m), 지름 15km의 화산
▶ 영상: https://cdn.sanity.io/files/4zrzovbb/website/3a8b31b9b3525f607fc1da0c878b2ee1ea56e54c.mp4
금성의 작은 순상화산
계산 생물학. 계산 생물학에서는 작업별 기계 학습 모델을 GPU에서 실행하는 일이 흔합니다. 따라서 이러한 모델의 속도는 연구 진전의 병목이 됩니다. Mythos 5.1은 이 문제에 대한 하나의 해법을 제공했습니다. 맞춤형 GPU 커널을 작성하고 중간 결과를 캐시함으로써, 동일한 출력으로 7개의 오픈소스 딥러닝 모델의 속도를 최대 2.5배까지 높였습니다.
이러한 속도 향상의 이점은 빠르게 누적됩니다. 하나의 실험에서 생물학자들은 이 모델을 수천 번 실행할 수 있습니다(예를 들어, 모든 인간 유전자 근처의 가능한 모든 돌연변이를 테스트하는 경우). 이런 분석에서는 최적화된 모델이 추정 GPU 비용을 30~60% 줄였습니다. 이런 종류의 최적화는 보통 성능 엔지니어 팀이 몇 주에 걸쳐 해야 하는 작업이며, 학술 연구실에서는 감당하기 어려운 경우가 많습니다. Mythos 5.1은 공개된 소스 코드만으로도 불과 며칠 만에 이를 해낼 수 있었습니다. 우리는 이러한 최적화를 곧 오픈소스로 공개할 계획입니다.
추론 속도 향상
추론 속도 향상
NVIDIA H100에서 7개의 오픈소스 단백질 및 유전체학 모델에 대한 추론 속도 향상
전장 유전체 분석에서의 예상 비용 절감
전장 유전체 분석에서의 예상 비용 절감
- 원래 구현
- 최적화됨
클라우드 정가 기준으로, 최적화 전후의 세 가지 전장 유전체 분석에 대한 예상 GPU 비용. Evo 2 40B는 일부 최적화가 많은 시퀀스에 걸쳐서만 효과를 내기 때문에, 전체 작업 기준 절감 효과(2.3배)가 단일 forward 기준(1.4배)보다 더 큽니다.
우리 모델의 과학적 역량이 향상됨에 따라, 과학적 진전에 대한 우리의 투자도 커지고 있습니다. 지난주에는 Claude가 실험실 장비를 직접 그리고 안전하게 조작할 수 있게 해 주는 모델 하드웨어 표준을 미리 공개했습니다. 또한 최근에는 AI for Science 프로그램을 통해 과학자를 위한 지원을 확대했습니다. 이 프로그램은 영향력 큰 과학 프로젝트를 수행하는 연구자들에게 무료 크레딧을 제공하며, 새로 나온 Claude Team plan for scientists를 통해 대폭 할인된 사용 요금도 제공하고 있습니다.
안전성, 보안, 그리고 정렬
AI 모델의 에이전틱 능력은 지난 2년 동안 훨씬 더 강력해졌습니다. 하지만 기록했듯이, 더 큰 자율성은 새로운 위험을 동반합니다. 안전성, 보안, 정렬에 대한 작업은 AI 역량과 같은 속도로 발전해야 합니다. 어제 우리는 우리의 정렬 및 보안 노력을 어떻게 개선하고 있는지 설명하는 보고서를 발표했습니다
Claude Fable 5.1과 Claude Mythos 5.1을 출시하기에 앞서, 우리는(일부 경우 외부 연구자들과 함께) 여러 영역에 걸친 위험에 대해 모델을 광범위하게 테스트했습니다. 이러한 노력의 전체 내용은 System Card에 설명되어 있으며, 아래는 간략한 요약입니다.
화학 및 생물학적 위험. 우리는 Claude Mythos 5.1이 화학 또는 생물학 무기를 만드는 데 얼마나 도움이 될 수 있는지 시험했습니다. 이 과정에는 전문가 레드팀 테스트, 자동 평가, 그리고 박사급 생물학자와 AI 전문가를 짝지은 테이블탑 훈련이 포함되었으며, 모델이 인간 전문가의 성능과 견줄 수 있는지를 시험했습니다. Mythos 5.1의 능력은 Mythos 5보다 더 뛰어납니다. 그러나 우리의 평가는 이것이 여전히 책임 있는 확장 정책에서 정의한 다음 위험 단계에는 미치지 못함을 보여줍니다. 따라서 우리는 Mythos 5에 적용했던 동일한 안전장치를 Mythos 5.1에도 적용하여 배포하고 있으며, 이는 연구용 생물학 기능에 대한 접근을 제한합니다.
사이버 위험. 우리는 Claude Mythos 5.1의 사이버 능력을 평가하기 위해 일련의 평가를 수행했습니다(사이버보안 안전장치를 끈 상태에서). 전반적으로 이 모델은 우리가 출시한 어떤 모델보다도 가장 강력한 사이버 능력을 보여주지만, 여전히 Frontier Compliance Framework에서 낮은 위험 범주에 속합니다. 또한 우리는 Fable 5.1의 사이버보안 안전장치에 대해 광범위한 스트레스 테스트를 수행했습니다. 자체적인 동적 강건성 평가 외에도, Gray Swan의 자동화 테스트와 함께 두 개 조직에 외부 테스트를 의뢰했습니다. Fable 5 및 Opus 5와 마찬가지로, 우리는 이러한 안전장치에 대한 치명적 심각도의 탈옥 증거를 찾지 못했습니다.
에이전트 안전성. 우리는 Claude Mythos 5.1이 악의적 요청과 프롬프트 인젝션(AI 모델이 처리하는 콘텐츠 안에 숨겨진 적대적 지시)에 어떻게 반응하는지 평가했습니다. 이 모델은 악의적인 에이전트 코딩 및 컴퓨터 사용 요청을 Mythos 5, Sonnet 5, Opus 5와 비슷한 비율로 거부했으며, 외부 프롬프트 인젝션 벤치마크에서는 지금까지 우리가 보유한 모델 중 가장 강건한 성능을 보였습니다.
정렬. 우리는 정적 및 대화형 행동 평가, 자연어 오토인코더를 사용한 내부 사고 분석, 정렬 불일치 관련 능력 평가, 학습 데이터 검토, 그리고 내부 파일럿 사용 분석을 통해 모델의 행동을 테스트했습니다. 외부 테스트로부터의 보고도 받았습니다.
우리의 자동 행동 감사 결과, Claude Mythos 5.1은 대부분의 지표에서 이전 모델인 Mythos 5보다 더 잘 정렬되어 있는 것으로 나타났습니다. 이 모델은 불가능한 과제가 주어졌을 때 Mythos 5보다 테스트 환경 밖의 자원에 접근하려 시도할 가능성이 현저히 낮습니다. 또한 자신의 행동을 정당화하기 위해 동기화된 추론을 사용할 가능성도 Mythos 5보다 낮고(예를 들어 상황이 시뮬레이션이나 평가라고 추론하는 경우), 사용자의 목표를 달성하기 위해 명시적 제약을 무시할 가능성도 더 낮습니다. 학습 데이터 검토 결과, Mythos 5.1은 보상 해킹(또는 부정행위)을 시도하는 비율과 실제로 성공하는 비율이 모두 Mythos 5보다 전반적으로 낮았습니다.
전반적으로 정렬 평가는 개선을 보여주었지만, 우리의 테스트에서는 이 모델이 여전히 때때로 승인 절차와 자동 모드 분류기를 우회할 수 있음이 드러났습니다(이에 대해서는 시스템 카드에서 더 자세히 설명합니다). 정렬 평가가 제공하는 커버리지에도 한계가 있습니다. 현재 우리의 자동 행동 감사는 매우 긴 문맥 작업과 멀티 에이전트 설정에 대해서는 가시성이 더 낮습니다. 또한 불가능한 과제(더 비정상적이고 정렬이 어긋난 행동을 유발할 수 있음)에 대한 커버리지도 우리가 바라는 수준보다는 부족하지만, 우리는 이 영역에서 최근 개선을 이뤘고 앞으로도 계속 개선하기 위해 열심히 노력하고 있습니다.
우리는 또한 안전성을 훼손하지 않으면서 모델이 더 유용해질 수 있도록 안전장치를 개선했습니다. 이러한 변경 사항은 아래에서 설명합니다.
기업을 위한 자동화된 안전장치. 기업 최전선 안전장치 (EFS)는 제로 데이터 보존 계약의 개인정보 보호를 기업 고객에게 제공하는 동시에, 모델 오용을 탐지하고 대응할 수 있게 해줍니다. EFS를 통해 고객은 Anthropic의 시스템이 아니라 자신의 클라우드 인프라에 데이터를 저장합니다. 또한 기본적으로 모든 사람의 검토는 Anthropic이 아니라 고객 자신이 수행합니다. 우리는 금융 서비스, 의료, 제조, 통신, 법률, 소매, 공공 부문 등 다양한 산업의 100개 이상의 고객, 그리고 Amazon Web Services, Google Cloud, Microsoft Azure의 클라우드 파트너와 긴밀히 협력해 EFS를 개발했습니다.
EFS는 Claude Code, Claude Enterprise, Claude Platform, Amazon Bedrock, AWS의 Claude Platform, Google의 Agent Platform, Microsoft Foundry에서 지원될 예정입니다. 출시를 단계적으로 진행하고 있으며, 올가을부터 시작합니다. 위에서 언급한 것처럼, EFS 자격이 있는 고객은 EFS가 준비될 때까지 제로 데이터 보존 상태에서 Fable 5.1(및 Fable 5)을 사용할 수 있습니다. EFS에 대해 더 자세히 알아보려면 여기를 참고하세요. 액세스를 요청하려면 이 양식을 작성해 주세요.
생물학 및 사이버보안을 위한 더 정밀한 안전장치.지난 몇 달 동안 우리는 Fable 5.1의 안전장치를 더 정밀하게 만드는 데 진전을 이루었습니다. 즉, 의료 문제에 대한 질의나 모델을 사용해 시스템을 더 안전하게 만드는 사이버 방어자들처럼 무해한 콘텐츠에 대해 경고를 덜 하도록 하면서도, 실제 위협에 대해서는 강력한 보호를 제공하도록 했습니다.
우리가 최근 공유했듯이, Fable 5.1과 Fable 5를 위한 최신 생물학 안전장치는 기초 생물학 및 의학 질문과 관련된 무해한 요청에 대해 85% 더 적게 작동합니다(Fable 5와 함께 출시되었을 때의 기준 대비). 그러나 생명과학 연구개발과 관련된 질의는 계속해서 Opus 모델로 전달됩니다. 우리는 미국 정부와 협력해 개발한 Claude Mythos 5.1용 접근 프로그램을 통해 전문가들에게 모델의 생명과학 기능을 제공하고 있으며, 이에 대해서는 아래에서 설명합니다.
Fable 5.1에서는 사이버보안 안전장치를 더 정밀하게 업데이트하고 있습니다. 또한 이제 Fable 5.1을 소프트웨어 취약점 식별, 즉 소프트웨어 보안을 향상시키는 방어적 작업에 사용할 수 있도록 허용하고 있습니다. 이러한 변경의 결과로 Claude Code 사용자는 Fable 5의 이전 사이버 안전장치와 비교해 세션당 개입 횟수가 평균 약 60% 줄어들 것으로 예상할 수 있습니다. 다만 우리의 안전장치는 여전히 여러 종류의 이중용도 사이버보안 작업(도움이 될 수도 있고 유해할 수도 있는 작업)을 Opus 모델로 라우팅합니다. 여기에는 침투 테스트, 익스플로잇 생성, 바이너리 기반 취약점 스캐닝이 포함됩니다.
증류 방지 메커니즘. 증류는 고급 모델의 기능을 추출하는 데 사용되는 방법입니다. 이는 종종 수천 개의 가짜 계정을 사용해 산업 규모로 수행됩니다. 증류는 안전상 위험한데, 증류된 기능이 이후 적절한 안전장치 없이 배포될 수 있기 때문입니다. Fable 5.1에는 증류 공격을 더 어렵게 만드는 강화된 메커니즘이 포함되어 있습니다. 예를 들어, 이제 새로운 API 계정(오늘 이후 생성된 계정)은 Claude의 이전 사고 과정을 담은 대화 기록을 유지한 채, 다중 턴 대화에서 Claude의 이전 컨텍스트를 수동으로 편집할 수 없습니다. 이는 Claude의 사고를 불법적으로 추출할 수 있게 했던, 널리 알려진 공개 증류 기법을 차단합니다. 우리는 혼란을 최소화하기 위해 이 변경을 점진적으로 적용하고 있습니다. 기존 계정은 현재 이 변경의 영향을 받지 않지만, 앞으로의 모델 릴리스에서는 모든 사용자에게 적용될 것입니다. 그러면 소수 고객의 맞춤형 통합이 영향을 받게 됩니다. 우리의 도움말 센터 문서에서는 이 변경 사항과 개발자가 취할 수 있는 조정에 대해 더 자세히 설명합니다.
Claude Mythos 5.1에 대한 신뢰할 수 있는 액세스
Claude Mythos 5.1은 Fable 5.1과 동일하지만, 위에 설명된 사이버보안 및 생명과학 관련 제한으로 영향을 받는 검증된 개인과 조직을 위해 더 완화된 안전장치를 제공합니다. 이 모델은 두 가지 신뢰할 수 있는 접근 프로그램을 통해 제공됩니다:
- Cyber Verification Program: CVP는 현재 방어적 보안 작업을 위해 사이버 안전장치를 완화한 일부 Opus 및 Sonnet급 모델에 대한 접근을 제공합니다. 가까운 시일 내에 이 프로그램에는 Claude Mythos급 모델에 대한 접근도 포함될 예정입니다. 여기에서 CVP 가입을 신청하세요.
- Life Sciences Verification Program: LSVP는 생명과학 전문가가 전문적인 연구개발 활동을 위해 설계된 안전장치와 함께 Claude Mythos 5.1을 사용할 수 있도록 설계되었습니다(그 외의 모든 안전장치는 그대로 유지됩니다). 미국 정부와의 협력으로 우리는 첫 참가자를 등록했으며, 이 프로그램의 접근 권한을 더 넓은 생명과학 커뮤니티로 확대할 계획입니다.
이러한 신뢰할 수 있는 접근 프로그램 외에도, 취약점을 찾기 위해 코드베이스를 스캔하고 인간 검토를 위한 패치를 제안하는 우리의 제품 Claude Security도 이제 Claude Mythos 5.1로 구동됩니다.
EU AI Act 준수
2026년 7월, Anthropic은(190개의 다른 서명 기관과 함께, 여러 주요 AI 모델 제공업체 포함) AI 생성 콘텐츠의 투명성에 관한 EU AI Act의 실행 규범에 서명했습니다.
이에 따라 2026년 8월 2일 이후 출시된 모델의 출력물에 워터마크를 추가해야 했습니다. 워터마크는 Claude가 텍스트 작성에 관여했을 가능성을 수치적으로 판단하는 방식입니다. 최근 설명했듯이, 이 워터마크는 탐지 API가 없는 사람에게는 보이지 않습니다. 또한 Claude의 출력 품질이나 내용에 실질적인 영향을 주지 않으며, 사용자, 그 조직, 또는 Claude와의 대화에 관한 정보는 전혀 포함하지 않습니다.
이 법은 또한 사용자가 어떤 텍스트에 워터마크가 포함되어 있을 가능성이 있는지 확인할 방법을 제공하도록 요구했습니다. 이에 따라 우리는 프라이빗 프리뷰 형태로 탐지 API를 배포하고 있습니다. 이 API는 현재 EU 법률에 따라 자격을 갖춘 조직(예: 규제 기관, 법 집행 기관, 언론, 팩트체커, 독립 연구자, 교육 기관, EU 시민사회 단체)에서 사용할 수 있습니다. 또한 Act 준수를 위해 자체적으로 워터마킹 검증 의무를 지는 기업에도 제공됩니다. 앞으로 탐지 API에 대한 접근을 점차 확대할 계획입니다. 여기에서 접근에 대한 관심을 등록할 수 있습니다.
비용 및 이용 가능성
Claude Fable 5.1은 Amazon Web Services, Google Cloud, Microsoft Azure를 포함한 모든 플랫폼에서 오늘부터 사용할 수 있습니다. 개발자는 Claude API에서 claude-fable-5-1로 시작할 수 있습니다.
위에서 언급했듯이, API와 같이 사용량 기준으로 청구되는 곳에서는 Fable 5.1의 캐시 읽기(모델이 이미 처리한 컨텍스트를 재사용하는 기능) 가격을 낮췄습니다. 캐시 읽기 비용은 이제 75% 저렴해져서 백만 토큰당 \$0.25가 됩니다.
이 변경으로 모델을 운영하는 전체 비용이 크게 줄어듭니다. 일반적인 워크로드의 경우 Fable 5 대비 비용이 약 25% 감소합니다. 복잡한 코딩 및 고도로 에이전트적인 작업의 경우 절감 폭은 최대 약 45%에 이를 수 있습니다. 아래 그래프는 이 변화가 왜 그렇게 큰 차이를 만드는지 보여줍니다:
Fable 사용의 인덱스 비용
- 캐시 읽기
- 그 외 모든 토큰
2026년 8월의 실제 사용량을 기준으로 4주 동안 기본 노력 수준에서 측정한 사용량 기반 가격으로, Fable 5와 Fable 5.1에서 동일한 워크로드를 실행할 때의 인덱스 비용입니다. 일반 워크로드는 Claude Enterprise, Claude Code, API 전반의 Fable 사용을 포함합니다. 고도로 에이전트적인 워크로드는 컨텍스트가 많고 도구 사용이 많은 작업을 포함하며, 이 경우 캐시 읽기가 비용의 대부분을 차지합니다.
그 외의 Fable 5.1 가격은 Fable 5와 동일합니다: 입력 토큰 백만 개당 \$10, 출력 토큰 백만 개당 \$50입니다. 동시에 우리는 Fable 5.1의 여러 개선 사항을 나머지 모델 제품군에도 적용하기 위한 작업을 계속하고 있습니다.
위에서 논의한 바와 같이, Claude Mythos 5.1은 검증된 사이버 방어자와 생명과학자들에게 제공됩니다. 현재는 미국 내 일부 조직에만 제공되지만, 가능한 한 빨리 국내외 더 넓은 파트너 집단으로 접근 권한을 확대하기 위해 미국 정부와 조율하고 있습니다. CVP를 통해 사이버 방어용 Claude Mythos 5.1 접근에 관심을 등록하려면, 여기를 방문하세요.
시작하기
각주
[1] Terminal-Bench-Science 0.1: 표준 오차는 모델당 ±3.5–4.5점입니다. 공개 리더보드(작업당 3회 시도, Claude Code harness)는 Claude Opus 5가 30.0%, Claude Fable 5가 21.4%라고 보고합니다. 우리의 설정은 각각 29.0%와 24.7%로 재현했으며, 둘 다 오차 범위 내입니다.
[2] OSWorld 2.0: 점수는 벤치마크 저자들이 2026년 8월에 공개한 작업 릴리스를 기준으로 합니다. Fable 5와 Opus 5는 동일한 조건에서 다시 실행했습니다. 작업 파일이 이전 릴리스와 다르기 때문에, 이 수치는 이전에 공개된 OSWorld 2.0 결과와 직접 비교할 수 없으며, 그래서 경쟁 모델 점수를 표시하지 않았습니다
[3] 이 세 가지 대상은 (EGFR, Nipah G, 15-PGDH)이며 Adaptyv Bio의 단백질 설계 대회에서 나온 것입니다. Nipah G 비교는 수용체 결합 부위가 있는 G head를 표적으로 하는 de novo 설계와의 비교입니다(최고: 약 8–12 nM, N1032). Nick Boyd/Escalante Bio의 de novo 출품작은 다른 영역(스톡)을 표적으로 하며 약 1.4 nM에 도달했고(design_7), 이는 우리의 최고의 결합체와 비슷합니다.
추가 읽을거리
1. Claude Fable 5.1 및 Claude Mythos 5.1 시스템 카드. 카드 보기
2. Enterprise Frontier Safeguards에 대한 더 자세한 내용. 자세히 알아보기
3. Enterprise Frontier Safeguards에 대한 접근 요청. 양식 열기
4. 생물학 안전장치 개선에 대한 개요. 자세히 알아보기
5. 과학자를 위한 지원. 더 읽기
6. 단백질 설계에서 Claude의 이전 작업. 더 읽기
7. 수학에서 Claude의 이전 작업. 더 읽기
8. Model Hardware Standard에 대한 자세한 내용. 자세히 알아보기
출처
- 원문: https://www.anthropic.com/claude-fable-and-mythos-5-1 (2026-10-26 · anthropic.com)